Ein Large Language Model, das nur auf sein Training vertraut, weiß im Zweifel nichts über die Kündigungsfrist in deinem aktuellen Mietvertrag, die Preisliste deines Unternehmens von letzter Woche oder das interne Handbuch, das erst gestern aktualisiert wurde. Genau an diesem Punkt setzt Retrieval-Augmented Generation an, und genau deshalb lohnt es sich, RAG-Systeme bauen als konkrete, erlernbare Fähigkeit zu betrachten statt als abstraktes Buzzword. Wer bereits mit ChatGPT oder Claude arbeitet, kennt die Grenzen des reinen Modellwissens. Mit RAG verschieben sich diese Grenzen fundamental: Das Modell bekommt bei jeder Anfrage frisches, geprüftes Wissen aus deinen eigenen Dokumenten geliefert, statt zu raten oder zu halluzinieren.
Dieser Guide führt Schritt für Schritt durch die Architektur, die Kernkomponenten und die Werkzeuge, mit denen du selbst RAG-Systeme bauen kannst, praxisnah, technisch fundiert und ohne unnötigen Ballast.
Inhaltsverzeichnis
Key Takeaways
- RAG kombiniert die Sprachfähigkeit von LLMs mit gezielter Dokumentensuche und reduziert dadurch Halluzinationen deutlich.
- Die drei zentralen Bausteine sind Chunking, Embeddings und eine Vektordatenbank, jede Komponente beeinflusst die Antwortqualität direkt.
- Die Pipeline folgt immer demselben Muster: Anfrage einbetten, ähnliche Chunks finden, Kontext in den Prompt schreiben, Antwort generieren.
- Frameworks wie LangChain und LlamaIndex übernehmen viel Grundarbeit, ersetzen aber nicht sauberes Chunking und Evaluation.
- Moderne Produktionssysteme setzen zunehmend auf Hybrid-Retrieval (Vektor plus Keyword) und Reranking statt reiner Vektorsuche.
Warum überhaupt RAG-Systeme bauen?
LLMs sind mit einem Wissensstichtag trainiert und kennen weder deine internen Dokumente noch aktuelle Ereignisse danach. Fehlt Kontext, füllen Modelle Lücken oft mit plausibel klingenden, aber falschen Aussagen, das bekannte Halluzinationsproblem. RAG löst dieses Problem, indem es dem Modell zur Laufzeit relevante Textausschnitte aus einer eigenen Wissensbasis mitgibt, bevor es antwortet.
Wer statt einer Wissensdatenbank ein eigenes Modell trainieren möchte, sollte vorher den Vergleich in Fine-Tuning vs Prompt Engineering: Wann lohnt sich das Training eigener KI-Modelle? lesen. Wer beim Formulieren der Abfragen an das Sprachmodell noch unsicher ist, findet Grundlagen in unserem Leitfaden Prompt Engineering für Einsteiger: So bekommst du bessere KI-Antworten.Der Vorteil gegenüber einem klassischen Fine-Tuning: Du musst das Modell nicht neu trainieren, wenn sich Inhalte ändern. Ein neues Dokument in der Wissensdatenbank reicht aus. Das macht RAG besonders attraktiv für Unternehmen, die interne Handbücher, Support-Tickets, Vertragsdokumente oder Produktkataloge durchsuchbar machen wollen, aktuell, nachvollziehbar und ohne das Modell selbst anzufassen.
Vektor-Datenbanken sind dabei die Suchmaschine im Hintergrund: hochoptimierte Systeme, um aus Millionen von Textabschnitten die semantisch ähnlichsten in Millisekunden zu finden, aber sie allein reichen nicht aus, um korrekte Antworten zu garantieren [2].
Die Kernkomponenten beim RAG-Systeme bauen
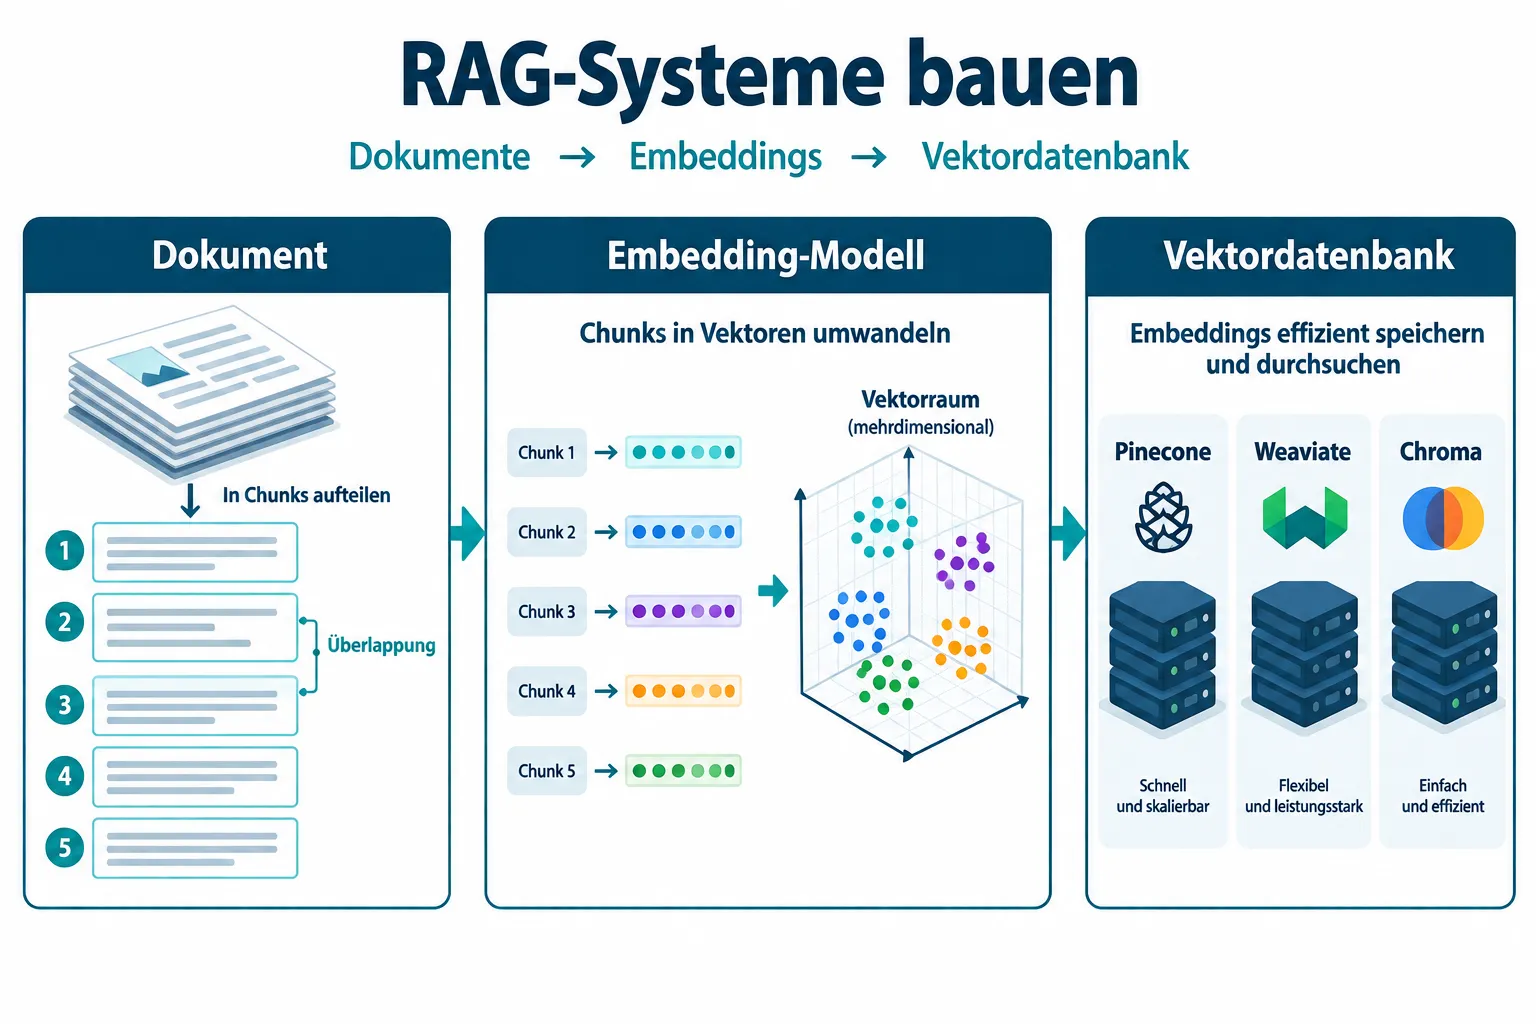
Wer RAG-Systeme bauen will, muss drei Bausteine verstehen und aufeinander abstimmen: Chunking, Embeddings und die Vektordatenbank. Jede Schwachstelle in einem dieser Bausteine wirkt sich direkt auf die Antwortqualität aus.
Chunking: Dokumente sinnvoll zerteilen
Bevor irgendetwas eingebettet werden kann, müssen Dokumente in überschaubare Abschnitte, sogenannte Chunks, zerlegt werden. Zu große Chunks verwässern die Relevanz der Suche, zu kleine Chunks reißen Sätze aus ihrem Kontext.
Bewährte Richtwerte:
- Chunk-Größe: meist 300 bis 800 Tokens, abhängig vom Dokumenttyp
- Overlap: 10 bis 20 Prozent Überlappung zwischen benachbarten Chunks, damit Informationen an Grenzen nicht verloren gehen
- Struktur nutzen: Überschriften, Absätze und Tabellen als natürliche Trennlinien verwenden statt starrer Zeichenlimits
Neuere Ansätze wie semantisches Chunking gruppieren Sätze nach inhaltlicher Ähnlichkeit statt nach fester Tokenzahl, was besonders bei heterogenen Dokumenten die Kontexttreue verbessert. Für rechtliche oder technische Dokumente mit klarer Struktur lohnt sich zusätzlich eine hybride Suche, die exakte Textstellen über Keyword-Matching findet, reine semantische Ähnlichkeit garantiert nämlich nicht automatisch die richtige Antwort [14].
Embeddings: Text in Vektoren verwandeln
Ein Embedding-Modell übersetzt Text in einen Vektor, eine Liste von Zahlen, die die Bedeutung des Textes in einem mathematischen Raum kodiert. Semantisch ähnliche Texte landen nahe beieinander, unabhängig von der exakten Wortwahl. Diese Eigenschaft macht es möglich, eine Nutzerfrage mit völlig anderen Worten trotzdem mit dem passenden Dokumentenabschnitt zu verknüpfen.
Vektordatenbanken im Vergleich
Die Vektordatenbank speichert diese Embeddings und ermöglicht die schnelle Ähnlichkeitssuche. Die Wahl hängt stark vom Anwendungsfall ab:
| Lösung | Stärke | Typischer Einsatz |
|---|---|---|
| Pinecone | Vollständig gemanagt, sehr niedrige Latenz bei hoher Anfragelast | Produktions-RAG mit Skalierungsanforderung [5][7] |
| Weaviate | Open Source, gut für große oder On-Premise-Deployments | Unternehmen mit Compliance-Anforderungen [3][10] |
| Chroma | Leichtgewichtig, lokal einsetzbar | Prototypen und kleinere Projekte [3] |
| Qdrant | Selbst gehostet, sehr performant | Latenzkritische Eigenbetriebe [5][10] |
| pgvector | Erweiterung für PostgreSQL | Teams mit bestehendem Postgres-Stack [10] |
"Semantisch ähnlicher Text ist nicht automatisch die richtige Antwort", dieser Grundsatz sollte jede Entscheidung für eine Retrieval-Strategie leiten [14].
Bevor du dich festlegst, lohnt sich ein realistischer Test: einen Satz von mindestens 200 Beispielanfragen mit typischen Schwierigkeiten, Umschreibungen, Fachbegriffe, mehrstufige Fragen, gegen denselben Datenbestand in mehreren Kandidaten laufen lassen und Recall, Antwortgenauigkeit und Latenz unter realistischer Last vergleichen, statt Herstellerangaben blind zu vertrauen [4].
Die Retrieval-Plus-Generation-Pipeline im Detail
Der eigentliche Ablauf beim RAG-Systeme bauen folgt immer demselben Grundmuster, unabhängig davon, welche Tools im Hintergrund laufen:
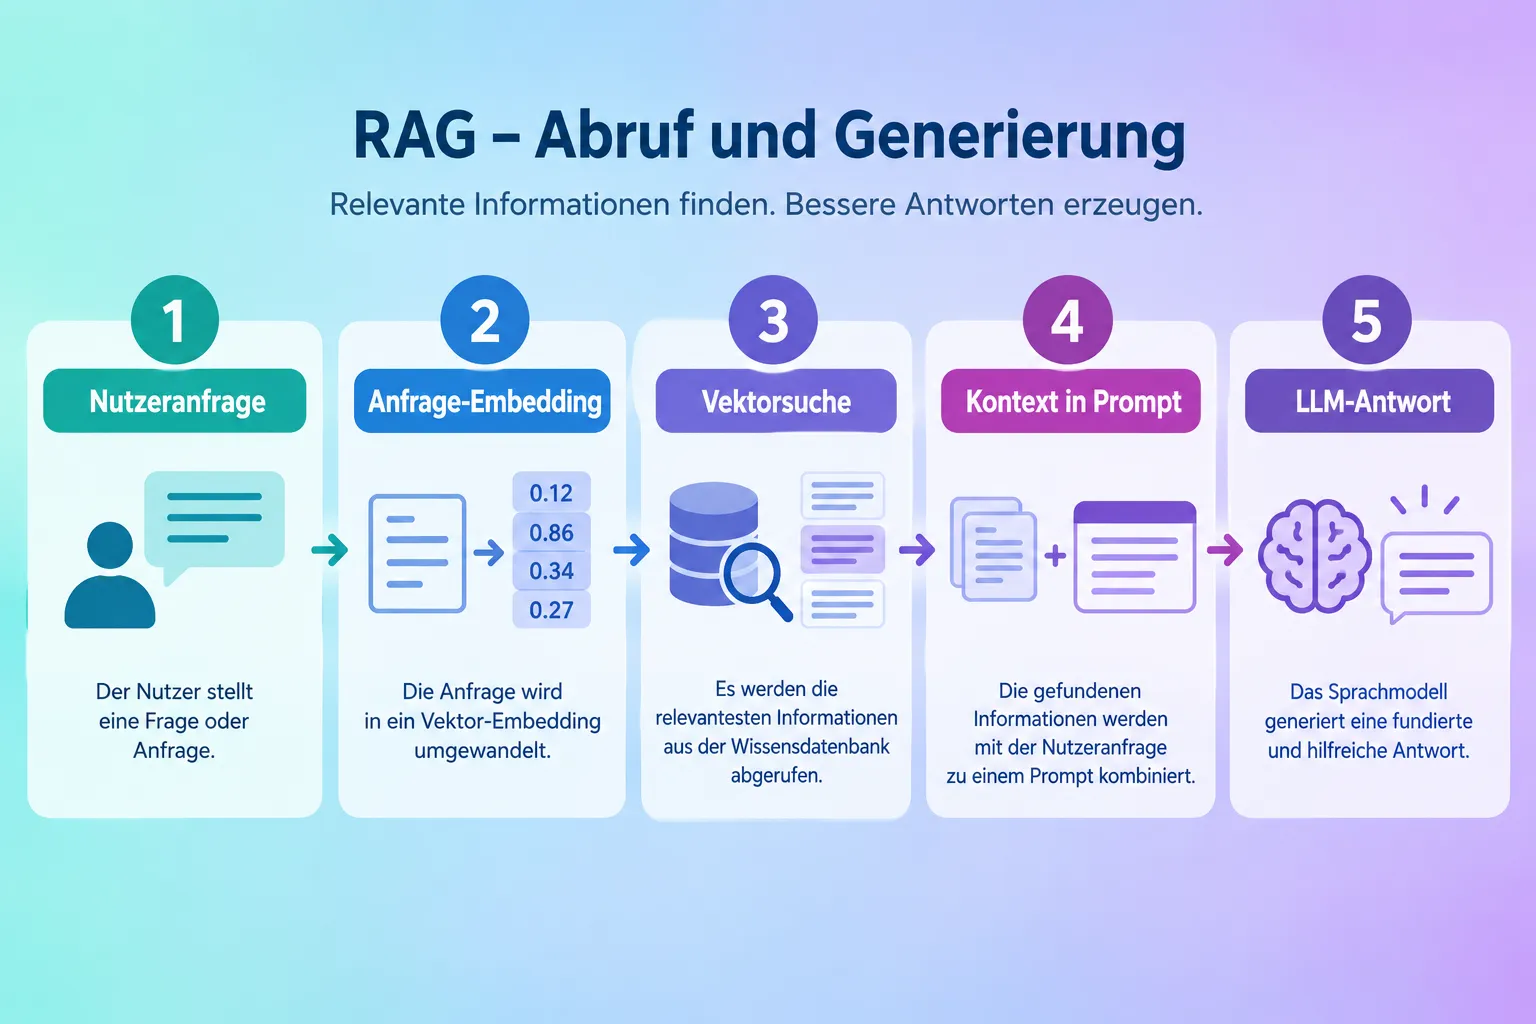
- Nutzeranfrage: Der Nutzer stellt eine Frage in natürlicher Sprache.
- Embedding der Anfrage: Dieselbe Embedding-Methode wie bei den Dokumenten wandelt die Frage in einen Vektor um.
- Vektorsuche: Die Datenbank sucht die Chunks, deren Vektoren der Anfrage am nächsten liegen, oft kombiniert mit Keyword-Suche und einem Reranking-Schritt, um die Trefferliste zu schärfen.
- Kontext in den Prompt einfügen: Die gefundenen Textausschnitte werden zusammen mit der ursprünglichen Frage in den Prompt geschrieben, meist mit einer Anweisung wie "beantworte ausschließlich auf Basis des folgenden Kontexts".
- LLM generiert die Antwort: Das Sprachmodell formuliert eine Antwort, die auf den bereitgestellten Fakten basiert, nicht auf reinem Trainingswissen.
Eine einfache Architektur-Skizze für dieses System sieht so aus: Ein Ingestion-Prozess lädt Dokumente, teilt sie in Chunks und schreibt Embeddings in die Vektordatenbank. Parallel dazu läuft ein Query-Prozess, der Nutzeranfragen entgegennimmt, ebenfalls einbettet, die Datenbank abfragt und die Treffer an das LLM weiterleitet. Beide Prozesse teilen sich dieselbe Vektordatenbank als zentrale Wissensbasis.
In Produktionsumgebungen kommt oft ein weiterer Schritt hinzu: Logging der abgerufenen Chunks, damit nachvollziehbar bleibt, worauf sich eine Antwort stützt, ein wichtiger Baustein, um Fehlerquellen systematisch zu reduzieren. Analysen zeigen, dass gezielte Optimierungen an Chunking, Retrieval und Prompt-Aufbau die Fehlerrate solcher Systeme drastisch senken können, wenn man sie konsequent misst statt nur zu vermuten [9].
Tools und Frameworks: LangChain und LlamaIndex
Für das eigenständige RAG-Systeme bauen musst du nicht jede Komponente von Grund auf programmieren. Zwei Frameworks dominieren aktuell das Feld, mit unterschiedlichem Fokus.
LangChain hat sich zu einer breiten Orchestrierungsschicht entwickelt, die Retrieval mit Agenten-Werkzeugen, Kostenkontrolle und Modell-Fallbacks verbindet. Es eignet sich besonders gut, wenn RAG nur ein Bauteil in einem größeren System ist, etwa wenn ein Agent Dokumente durchsucht, Teilaufgaben an Sub-Agenten delegiert und Ergebnisse zusammenführt. Wichtig für den produktiven Einsatz: LangChains Standardkomponenten bringen einen gewissen Overhead mit sich, und Tracing-Funktionen können bei hohem Durchsatz spürbar Speicher verbrauchen. Wer viele Anfragen pro Tag verarbeitet, sollte Chains schlank halten und Retrieval-Ergebnisse aggressiv zwischenspeichern.
LlamaIndex positioniert sich klarer als Datenframework für RAG und Wissensdatenbanken. Es bietet fertige Bausteine für Datenanbindung, Indexierung (etwa VectorStoreIndex oder Keyword-basierte Retriever), Query Engines für komplexe, mehrstufige Fragen und eingebaute Evaluationsmetriken wie Recall@k oder Groundedness. Besonders praktisch: Für heterogene Wissensbasen lassen sich Anfragen automatisch an spezialisierte Teilindizes weiterleiten, statt alles in einen einzigen, unübersichtlichen Datentopf zu werfen, etwa getrennt nach Finanzberichten und Präsentationen.
Eine kurze Orientierung:
- LangChain wählen, wenn RAG Teil eines größeren Agenten-Workflows mit mehreren Werkzeugen und Entscheidungsschritten sein soll.
- LlamaIndex wählen, wenn der Fokus klar auf einer strukturierten, gut evaluierbaren Wissensdatenbank liegt.
Wer bereits mit autonomen KI-Agenten und automatisierten Workflows experimentiert, wird feststellen, dass RAG dort meist als eines von mehreren Werkzeugen eingebunden wird, nicht als eigenständiges Endprodukt.
Praktischer Fahrplan: RAG-Systeme bauen in der Praxis
Der Einstieg gelingt leichter, wenn du klein beginnst und iterativ testest, statt sofort eine komplexe Architektur zu planen.
- Klein starten: Beginne mit einer lokalen Vektordatenbank wie Chroma und einem überschaubaren Dokumentenbestand, bevor du eine gemanagte Lösung einführst.
- Chunking zuerst testen: Experimentiere mit Chunk-Größe und Overlap, bevor du an Embeddings oder Modellwahl feilst, schlechte Chunks lassen sich später kaum durch bessere Modelle ausgleichen.
- Hybrid-Retrieval einplanen: Kombiniere von Anfang an semantische Suche mit klassischer Keyword-Suche für exakte Begriffe, Namen oder Codes.
- Reranking nicht vergessen: Ein zusätzlicher Reranking-Schritt vor der Prompt-Erstellung verbessert die Trefferqualität oft mehr als ein größeres Embedding-Modell.
- Systematisch evaluieren: Baue einen festen Satz an Testfragen mit bekannten richtigen Antworten und prüfe Kennzahlen wie Kontext-Relevanz und Faithfulness, bevor du live gehst [4].
- Skalierungspfad festlegen: Wächst die Wissensbasis, prüfe frühzeitig, ob eine selbst gehostete Lösung oder eine vollständig gemanagte Vektordatenbank besser zu Budget und Compliance-Anforderungen passt.
Für fortgeschrittene Anwendungsfälle mit mehrstufigem Schlussfolgern oder starken Entitätsbeziehungen, etwa in juristischen oder medizinischen Wissensbasen, lohnt sich zusätzlich ein Blick auf Knowledge-Graph-gestützte Ansätze, die RAG um strukturierte Beziehungswissen ergänzen [9][8].
Wenn du dich schon mit dem Bau autonomer KI-Systeme beschäftigst, lohnt sich auch ein Blick auf unseren Guide zu KI-Agenten und Automatisierung – dort erfährst du, wie autonome AI-Workflows 2026 wirklich funktionieren und wie sich das Konzept von RAG-Systemen sinnvoll damit kombinieren lässt.
Fazit
RAG-Systeme bauen ist keine Magie, sondern solides Ingenieurshandwerk: saubere Chunks, passende Embeddings, eine gut gewählte Vektordatenbank und eine Pipeline, die konsequent evaluiert wird. Wer diese Grundlagen beherrscht, kann eigene KI-Wissensdatenbanken aufbauen, die Halluzinationen reduzieren und aktuelles, firmeneigenes Wissen zuverlässig zugänglich machen.
Der beste nächste Schritt: Starte mit einem kleinen, klar begrenzten Dokumentenbestand, teste verschiedene Chunk-Größen, wähle eine Vektordatenbank passend zu deinem Skalierungsbedarf und baue von Anfang an eine einfache Evaluationsroutine ein. Von dort aus lässt sich das System schrittweise erweitern, bis hin zu komplexeren Architekturen, die RAG mit autonomen Agenten und mehrstufigen Workflows kombinieren.
References
[2] How Vector Databases Enable Rag And 9 Tools To Know In 2026 – https://www.instaclustr.com/education/vector-database/how-vector-databases-enable-rag-and-9-tools-to-know-in-2026/ [3] Top Vector Database Solutions – https://azumo.com/artificial-intelligence/ai-insights/top-vector-database-solutions [4] Best Vector Databases For Rag 2026 – https://futureagi.com/blog/best-vector-databases-for-rag-2026/ [5] Best Vector Databases For Rag 2026 Top 7 Picks – https://alphacorp.ai/blog/best-vector-databases-for-rag-2026-top-7-picks [7] Best Vector Databases 2026 – https://iternal.ai/insights/best-vector-databases-2026 [8] Best Vector Database Rag Applications 2026 – https://ranksquire.com/2026/02/26/best-vector-database-rag-applications-2026/ [9] Vector Databases Knowledge Graphs Rag 2025 – https://futureagi.com/blog/vector-databases-knowledge-graphs-rag-2025/ [10] Best Vector Databases Rag – https://engineersguide.substack.com/p/best-vector-databases-rag [14] How Vector Databases Enable Rag And 9 Tools To Know In 2026 – https://www.instaclustr.com/education/vector-database/how-vector-databases-enable-rag-and-9-tools-to-know-in-2026/
Häufige Fragen
Was bedeutet RAG (Retrieval-Augmented Generation)?
RAG kombiniert ein Sprachmodell mit einer externen Wissensdatenbank. Statt sich nur auf Trainingsdaten zu verlassen, holt sich das Modell relevante Informationen aus eigenen Dokumenten, bevor es antwortet.
Warum reicht ein Sprachmodell allein oft nicht aus?
Ein Sprachmodell kennt nur, was in seinen Trainingsdaten stand. Aktuelle, interne oder sehr spezifische Informationen wie Firmenhandbücher fehlen ihm, RAG schließt diese Lücke.
Was ist Chunking bei RAG-Systemen?
Chunking bedeutet, Dokumente in sinnvoll große Textabschnitte zu zerteilen, damit sie effizient in einer Vektordatenbank gespeichert und bei Bedarf präzise wiedergefunden werden können.
Welche Tools eignen sich zum Bauen eines RAG-Systems?
Verbreitete Frameworks sind LangChain und LlamaIndex, die Chunking, Embeddings und die Anbindung an Vektordatenbanken vereinfachen.