Ein einziges Modell, sechs verschiedene Ergebnisse: Bei identischer KI namens Kimi K3 schwankte die Erfolgsrate bei 26 identischen Programmieraufgaben zwischen 17 und 21 gelösten Tasks, und die Kosten variierten um das 3,8-fache. Das ist die zentrale Erkenntnis eines aktuellen Benchmark-Tests des KI-Agent-Anbieters Composio, der sechs Coding-Harnesses gegeneinander antreten ließ. Wer heute einen KI Coding Agenten Vergleich sucht, landet meist bei der Frage, welches Modell das beste ist. Die Studie zeigt: Die eigentlich entscheidende Frage lautet, welche Ausführungsumgebung, der sogenannte Harness, um dieses Modell herum gebaut wurde.
Für Entwickler-Teams, die täglich mit autonomen Coding-Assistenten arbeiten, ist das eine unbequeme, aber wertvolle Erkenntnis. Bevor teuer das Modell gewechselt wird, lohnt sich zuerst ein Blick auf das Framework, das es steuert.
Inhaltsverzeichnis
Key Takeaways
- Bei identischem Modell (Kimi K3) schwankte die Erfolgsrate zwischen 17/26 (Codex) und 21/26 (Kimi Code), nur wegen des Harness.
- Die Kosten pro Aufgabe reichten von 0,39 USD (Hermes Agent) bis 1,47 USD (Claude Code), ein Faktor von 3,7.
- Pi Agent war mit median 161,7 Sekunden pro Aufgabe am schnellsten, Claude Code mit 347,6 Sekunden mehr als doppelt so langsam.
- Codex scheiterte zweimal am 900-Sekunden-Zeitlimit bei einer Aufgabe, die Pi Agent in 446 Sekunden löste.
- Für die Tool-Auswahl gilt: Harness-Wechsel testen, bevor teure Modell-Upgrades in Erwägung gezogen werden.
Was wurde getestet: Der Composio-Benchmark im Detail
Der Anbieter Composio, spezialisiert auf Infrastruktur für KI-Agenten, veröffentlichte den Vergleich über einen X-Thread. Getestet wurden sechs Harnesses, Kimi Code, Hermes Agent, Pi Agent, Claude Code, OpenCode und Codex, jeweils mit demselben zugrunde liegenden Modell Kimi K3. Alle sechs Kombinationen mussten dieselben 26 agentischen Aufgaben lösen: reale, mehrstufige Coding- und Automatisierungs-Workflows, darunter auch ein komplexer Spesenprüfungs-Task mit mehreren Zwischenschritten.
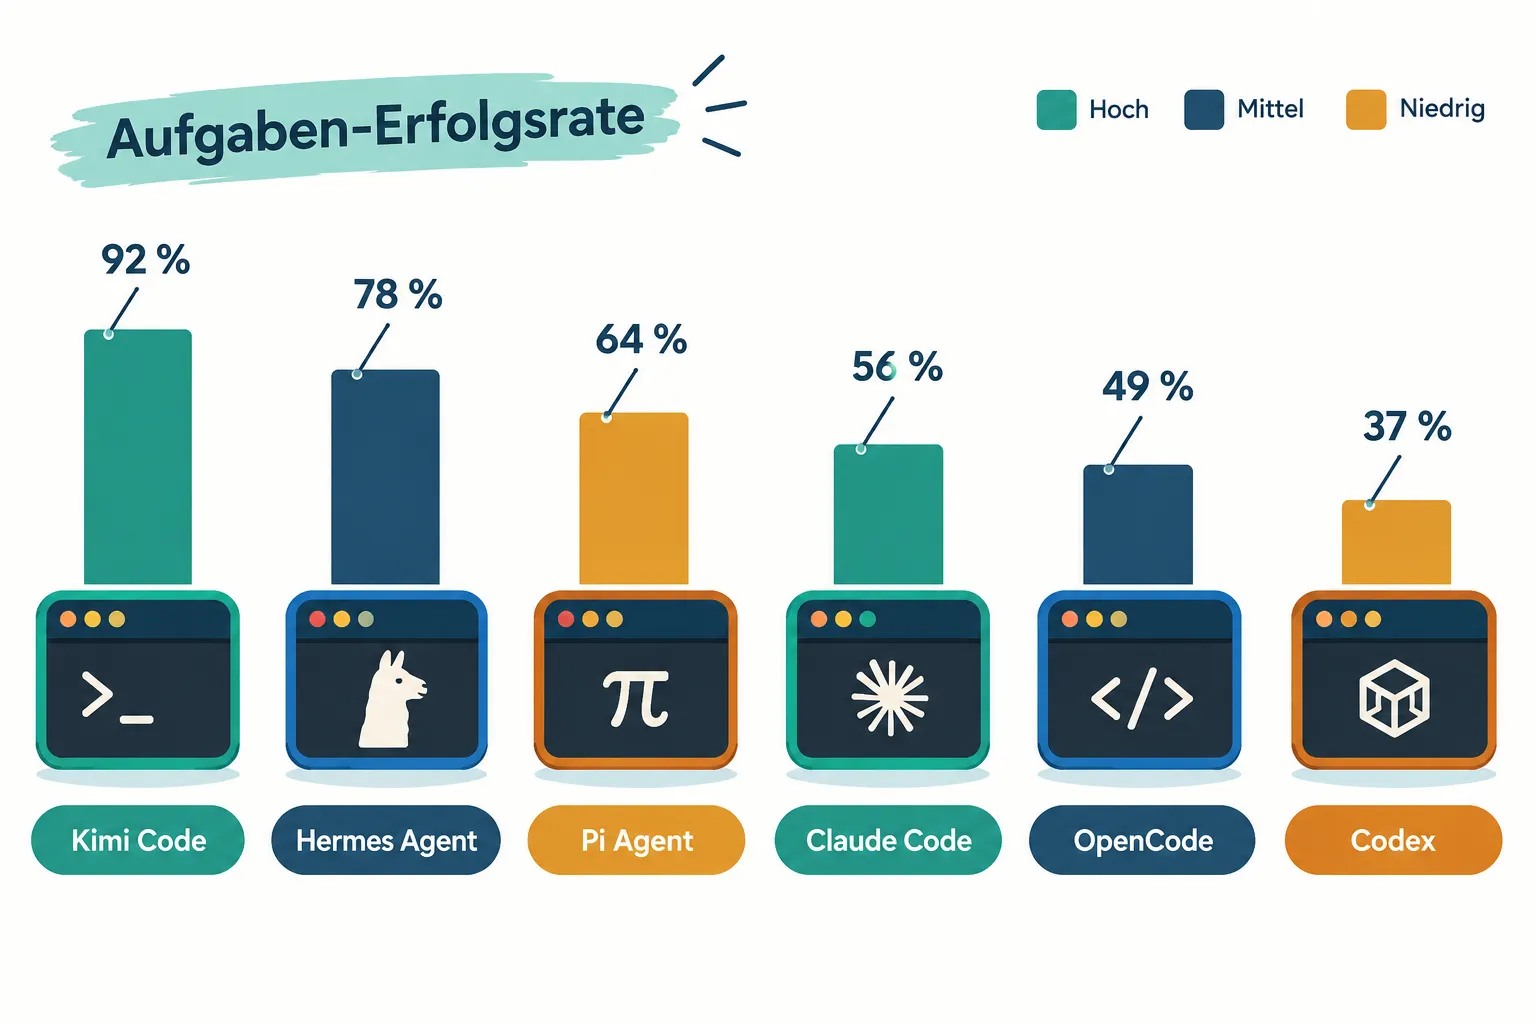
Wichtig ist der methodische Kern: Das Modell blieb konstant. Nur die Software-Schicht, die dem Modell Werkzeuge, Dateizugriff und Terminal-Berechtigungen gibt, unterschied sich. Damit lässt sich der Effekt des Harness isoliert messen, ohne dass Modellunterschiede das Ergebnis verzerren. Genau diese kontrollierte Testanordnung macht den Composio-Vergleich für einen fundierten KI Coding Agenten Vergleich so aussagekräftig.
KI Coding Agenten Vergleich: Die Ergebnisse in der Tabelle
Die folgende Übersicht fasst alle drei gemessenen Kennzahlen zusammen: Erfolgsrate, durchschnittliche Kosten und Median-Laufzeit pro Aufgabe.
| Harness | Erfolgsrate (von 26) | Kosten pro Aufgabe (USD) | Median-Zeit pro Aufgabe |
|---|---|---|---|
| Kimi Code | 21/26 | 0,54 | 297,1 s |
| Hermes Agent | 20/26 | 0,39 | 179,5 s |
| Pi Agent | 19/26 | 0,40 | 161,7 s |
| Claude Code | 19/26 | 1,47 | 347,6 s |
| OpenCode | 18/26 | 0,51 | 271,1 s |
| Codex | 17/26 | 0,47 | 236,2 s |
Drei Muster fallen sofort auf. Erstens: Der Spitzenreiter bei der Erfolgsrate, Kimi Code, ist nicht der günstigste, aber auch nicht der teuerste Harness. Zweitens: Pi Agent liefert das beste Verhältnis aus Geschwindigkeit und Kosten, ohne bei der Erfolgsrate stark abzufallen. Drittens: Claude Code ist mit 1,47 USD pro Aufgabe rund 3,7-mal teurer als Pi Agent, erreicht aber eine niedrigere Erfolgsrate als Kimi Code und Hermes Agent. Wer nur nach Bekanntheit des Namens entscheidet, würde hier möglicherweise die schlechtere Wahl für den eigenen Anwendungsfall treffen.
Was ist ein Harness? Erklärung für Einsteiger
Wer sich nicht täglich mit Agenten-Architekturen beschäftigt, stolpert schnell über den Begriff. Ein Harness ist im Kern die Software-Umgebung, die ein KI-Sprachmodell mit der realen Arbeitsumgebung verbindet. Das Modell selbst, etwa Kimi K3, kann nur Text generieren. Es weiß nicht automatisch, wie es eine Datei öffnet, ein Terminal-Kommando ausführt oder eine Codeänderung testet.
Genau hier kommt der Harness ins Spiel. Er stellt dem Modell Werkzeuge bereit, etwa:
- Dateizugriff zum Lesen und Schreiben von Code
- Terminal-Kommandos zum Ausführen von Skripten
- Gedächtnis- und Kontext-Management über mehrere Schritte hinweg
- Fehlerbehandlung, wenn ein Schritt nicht funktioniert
- Regeln, wann eine Aufgabe als abgeschlossen gilt
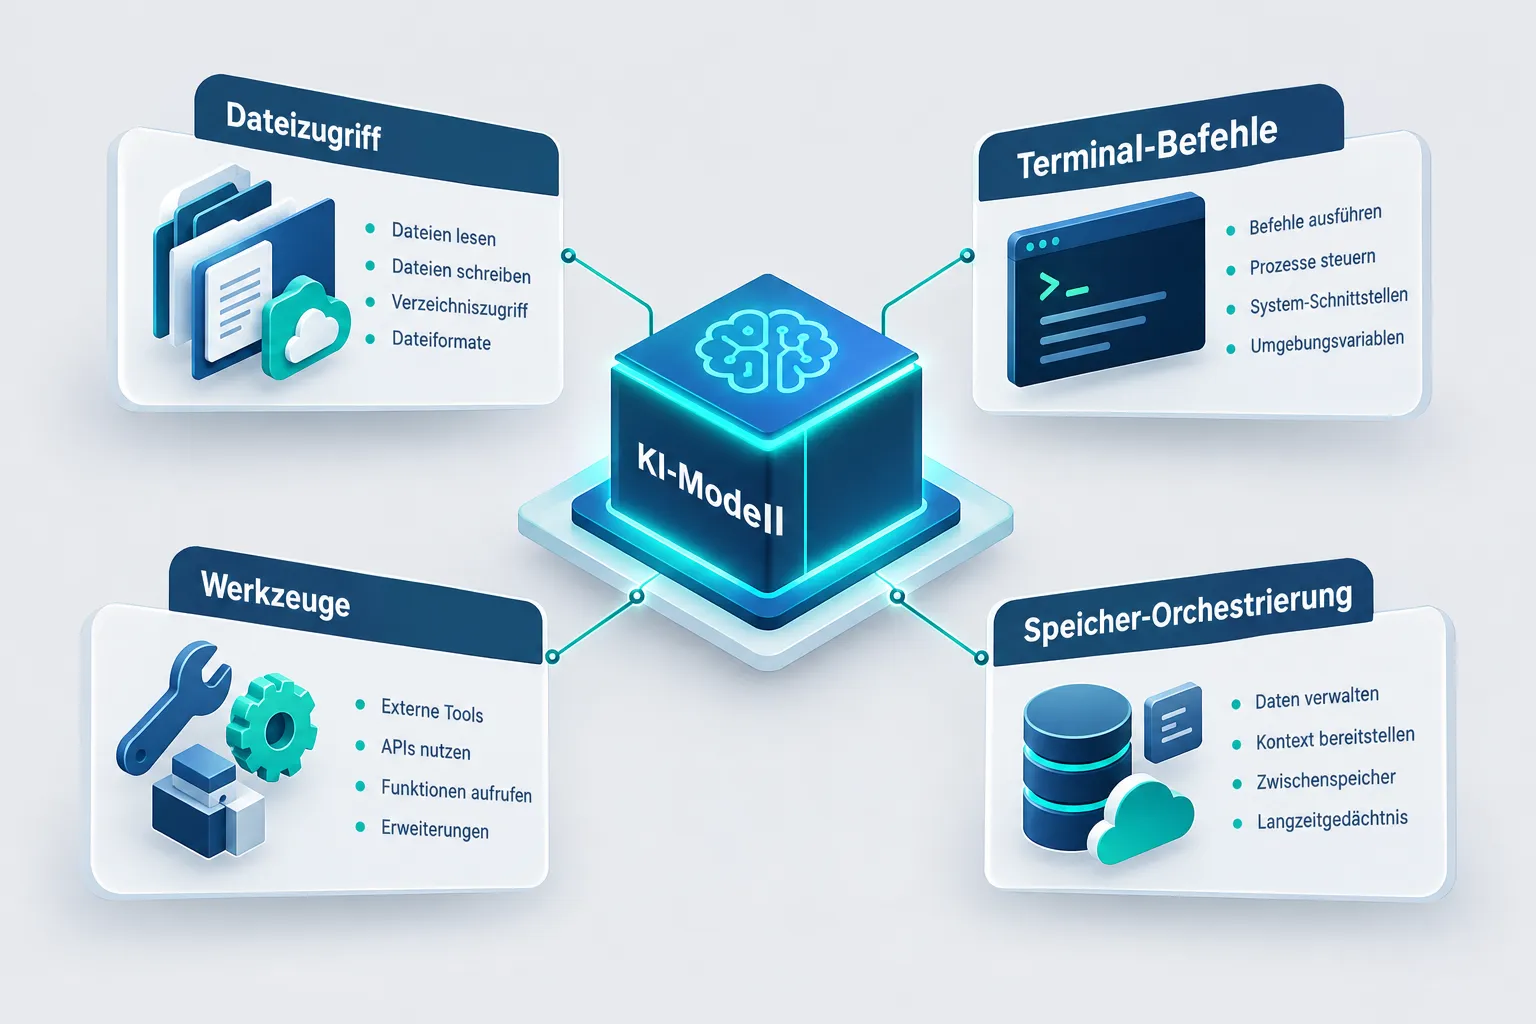
Zwei Harnesses können also dasselbe Modell nutzen und trotzdem völlig unterschiedlich arbeiten, je nachdem, wie effizient sie Zwischenschritte planen, wie sparsam sie mit Tokens umgehen und wie robust sie mit Fehlern umgehen. Genau das erklärt, warum ein KI Coding Agenten Vergleich niemals nur eine Modellfrage sein sollte, sondern immer auch eine Frage der Ausführungsarchitektur ist.
Warum der Harness wichtiger ist als das Modell
Die Kernaussage der Composio-Studie lässt sich so zusammenfassen: Bevor Teams das Modell wechseln, um Kosten zu senken oder die Zuverlässigkeit zu verbessern, sollten sie zuerst einen anderen Harness testen. Bei identischen Aufgaben mit identischem Modell veränderte allein die Wahl des Harness die Kosten pro Aufgabe um das 3,8-fache und die Erfolgsrate von 17 auf 21 von 26 Aufgaben.
Diese Beobachtung deckt sich mit unabhängigen Analysen aus dem breiteren Markt. Eine detaillierte Harness-Bench-Studie mit 106 Aufgaben, sechs Harnesses und acht Modellen kam zu einem ähnlichen Ergebnis: Die beste Harness-Konfiguration erreichte 76,2 Punkte, die schlechteste nur 52,4, ein Abstand von 23,8 Punkten auf identischen Modellen und Aufgaben [14]. Bemerkenswert ist zudem, dass rund 36 Prozent der beobachteten Fehler nicht auf mangelndes Schlussfolgern des Modells zurückgingen, sondern auf Schema- und Output-Contract-Verstöße, also auf Schwächen im Harness selbst [14].
"Bei identischen Aufgaben mit identischem Modell veränderte allein die Wahl des Harness die Erfolgsrate von 17 auf 21 von 26 Aufgaben."
Wer neben kommerziellen Coding-Agenten auch nach kostenlosen Alternativen sucht, findet in unserer Übersicht zu Open Source GitHub Tools weitere Optionen. Auch ein Vergleich mehrerer Coding-Harnesses mit demselben Claude-Modell (Opus 4.5) auf dem Terminal-Bench-2.0-Benchmark bestätigt das Muster: Letta Code erreichte 59,1 Prozent Erfolgsrate, während Claude Code mit demselben Modell nur auf 41,6 Prozent kam, ein Unterschied, der ausschließlich auf die Harness-Architektur zurückgeführt wurde [13]. Analysten erwarten, dass die größten Performance-Sprünge bis Ende 2026 weniger von neuen Basismodellen kommen als von spezialisierten Harnesses mit strengeren Output-Verträgen und feinerer Speicher-Orchestrierung [13][14].
Codex und die 900-Sekunden-Grenze: Ein Fallbeispiel
Besonders aufschlussreich ist ein konkretes Detail aus dem Composio-Test. Codex, der Harness mit der niedrigsten Erfolgsrate im Vergleich, scheiterte gleich zweimal an einem festen Zeitlimit von 900 Sekunden bei einem Spesenprüfungs-Task. Pi Agent löste dieselbe Aufgabe in nur 446 Sekunden, weniger als der halben Zeit.
Das zeigt, dass Schwächen im Harness besonders bei den größten und komplexesten Workflows sichtbar werden. Kleinere, einstufige Aufgaben lassen Unterschiede zwischen Harnesses oft kaum erkennen. Sobald jedoch mehrstufige Prozesse mit vielen Zwischenschritten anstehen, entscheidet die Effizienz der Planung, des Tool-Einsatzes und der Fehlerbehandlung darüber, ob eine Aufgabe überhaupt innerhalb eines praktikablen Zeitfensters gelöst wird. Für Teams, die komplexe Automatisierungen bauen, ist dieses Detail möglicherweise wichtiger als die reine Erfolgsquote in der Gesamttabelle.
KI Coding Agenten Vergleich: Was bedeutet das für Entwickler-Teams
Für die praktische Tool-Auswahl lassen sich aus den Daten mehrere handlungsleitende Schlüsse ziehen:
- Harness vor Modell testen: Wer Kosten senken oder Zuverlässigkeit verbessern will, sollte zuerst prüfen, ob ein anderer Harness mit dem bestehenden Modell bessere Ergebnisse liefert, bevor teure Modell-Upgrades erfolgen.
- Anwendungsfall entscheidet: Für kurze, häufige Aufgaben lohnt sich ein günstiger, schneller Harness wie Pi Agent oder Hermes Agent. Für komplexe, seltene Workflows mit hohem Anspruch an Erfolgsrate kann ein teurerer Harness wie Kimi Code trotz höherer Kosten pro Aufgabe wirtschaftlicher sein, weil weniger Wiederholungsversuche nötig sind.
- Zeitlimits prüfen: Feste Timeout-Grenzen in einem Harness können bei großen Workflows zum limitierenden Faktor werden, unabhängig von der Modellqualität.
- Kosten pro erfolgreicher Aufgabe berechnen, nicht nur Kosten pro Versuch: Ein günstiger Harness mit niedriger Erfolgsrate kann in der Gesamtrechnung teurer sein als ein etwas kostspieligerer Harness mit hoher Trefferquote.
Diese Prinzipien gelten unabhängig vom aktuellen Marktführer. Auch in anderen Benchmarks zeigen sich ähnliche Effekte: Auf Terminal-Bench 2.1 erreichte etwa der Codex-CLI-Harness mit dem Modell GPT-5.6 Sol einen Spitzenwert von 89,5 Prozent [11], während Claude Code mit dem Modell Fable 5.1 und einem Kontextfenster von 1 Million Tokens auf Terminal-Bench 4.0 eine Erfolgsrate von 57,9 Prozent erzielte und dort als führend für repository-nahe Arbeit eingestuft wurde [3]. Die Rangfolge verschiebt sich also je nach Benchmark, Modellpaarung und Aufgabentyp, ein weiterer Beleg dafür, dass ein pauschales „bester Agent" ohne Kontext wenig aussagekräftig ist.
Einordnung in den breiteren Markt 2026
Der Composio-Test ist kein Einzelfall, sondern passt in ein größeres Bild. Verschiedene Marktübersichten aus dem Jahr 2026 zeigen, dass Claude Code, OpenAI Codex, Cursor und GitHub Copilot jeweils bei unterschiedlichen Aufgabenformen die Nase vorn haben: Claude Code punktet bei komplexen Refactorings, Codex bei agentenbasierter Delegation, Cursor als IDE-Treiber und Copilot als Enterprise-Standard [2][4][8]. Terminal- und Agent-Rankings betonen zudem, dass Codex-basierte Harnesses bei terminal-orientierten Aufgaben und Computer-Interaktionen oft führend sind, unter anderem durch bis zu 1,9-fach schnellere Interaktionen im Mind2Web-Benchmark [3].
Preislich zeigt sich ein breites Spektrum: Leistungsstarke Harnesses wie Claude Code, Codex-CLI und IDE-Agenten wie Cursor oder Copilot bewegen sich meist zwischen 20 und 200 US-Dollar pro Monat, während Open-Source-Alternativen wie Cline oder OpenCode mit eigenem API-Zugang kostenfrei nutzbar sind und im wachsenden MCP-Tool-Ökosystem an Bedeutung gewinnen [6][9][10]. Diese Preisspanne macht deutlich: Die im Composio-Test gemessenen Unterschiede von wenigen Cent pro Aufgabe können sich bei tausenden täglichen Ausführungen zu erheblichen monatlichen Summen aufsummieren.
Fazit
Der Composio-Benchmark liefert einen seltenen, methodisch saubereren Blick auf eine Frage, die in der Praxis oft übersehen wird: Nicht nur das Modell, sondern vor allem der Harness bestimmt, wie zuverlässig, schnell und günstig ein KI-Coding-Agent tatsächlich arbeitet. Bei identischem Modell schwankte die Erfolgsrate zwischen 17 und 21 von 26 Aufgaben, die Kosten variierten um das 3,8-fache, und die Laufzeiten unterschieden sich um mehr als das Doppelte.
Für Entwickler-Teams bedeutet das: Vor dem nächsten teuren Modell-Upgrade lohnt sich ein systematischer Harness-Test mit dem eigenen bestehenden Modell und den eigenen typischen Aufgaben. Ein solcher interner KI Coding Agenten Vergleich, auch mit einer kleineren Auswahl von zehn bis zwanzig repräsentativen Tasks, liefert oft aussagekräftigere Ergebnisse als jede allgemeine Bestenliste. Wer zusätzlich feste Zeitlimits, Kosten pro erfolgreicher Aufgabe und die Fehlerarten dokumentiert, gewinnt eine belastbare Grundlage für die nächste Tool-Entscheidung, unabhängig davon, welches Modell darunter gerade den Markt anführt.
References
[1] Best Ai Agents – https://www.datacamp.com/de/blog/best-ai-agents [2] Beste Ki Coding Agenten 2026 – https://techsy.io/de/blog/beste-ki-coding-agenten-2026 [3] Coding Ai Agents For Accelerating Engineering Workflows – https://mightybot.ai/blog/coding-ai-agents-for-accelerating-engineering-workflows/ [4] Best Ai Agent For Coding – https://myclaw.ai/de/blog/best-ai-agent-for-coding [5] Best Ai Model For Coding 2026 – https://blink.new/de/blog/best-ai-model-for-coding-2026 [6] Die Besten Ki Coding Tools – https://jens.marketing/die-besten-ki-coding-tools/ [8] Best Ai Agents – https://myclaw.ai/de/blog/best-ai-agents [9] Best Ai Coding Agents 2026 – https://nimbalyst.com/blog/best-ai-coding-agents-2026/ [10] Ai Coding Agents Complete Guide 2026 – https://codersera.com/blog/ai-coding-agents-complete-guide-2026/
Häufig gestellte Fragen
Was zeigt der Composio-Benchmark zum KI Coding Agenten Vergleich?
Der Composio-Benchmark testete sechs Coding-Harnesses (Kimi Code, Hermes Agent, Pi Agent, Claude Code, OpenCode und Codex) mit demselben Modell Kimi K3 an 26 identischen Programmieraufgaben. Die Erfolgsrate schwankte je nach Harness zwischen 17 und 21 von 26 gelösten Aufgaben, obwohl das Modell identisch war.
Was ist ein Harness bei KI-Coding-Agenten?
Ein Harness ist die Software-Umgebung, die ein KI-Sprachmodell mit Werkzeugen wie Dateizugriff, Terminal-Kommandos, Kontext-Management und Fehlerbehandlung verbindet. Das Modell selbst kann nur Text generieren; der Harness entscheidet, wie effizient es diese Fähigkeiten in echte Aufgaben umsetzt.
Welcher Harness war im Test am günstigsten und welcher am teuersten?
Hermes Agent war mit 0,39 USD pro Aufgabe am günstigsten, Claude Code mit 1,47 USD pro Aufgabe am teuersten, ein Faktor von rund 3,7.
Welcher Harness hatte die höchste Erfolgsrate und wie schnell war Pi Agent?
Kimi Code erreichte mit 21 von 26 gelösten Aufgaben die höchste Erfolgsrate. Pi Agent war mit median 161,7 Sekunden pro Aufgabe am schnellsten, während Codex zweimal am 900-Sekunden-Zeitlimit scheiterte.