Ein einziger fehlender Index kann eine Query von 2 Millisekunden auf 8 Sekunden verlangsamen, bei identischer Datenmenge, identischer Hardware, identischem Code. Genau das ist der Punkt, an dem viele Backend-Entwickler mit MySQL-Grundkenntnissen an eine unsichtbare Wand stoßen: Die Anwendung läuft im Test butterweich, aber unter Produktionslast bricht die Datenbank Performance Optimierung förmlich zusammen. Wer bereits die Grundlagen aus PHP, Node.js und MySQL kennt, ist jetzt bereit für den nächsten Schritt: zu verstehen, warum Indizes funktionieren, wie man sie mit EXPLAIN seziert und wo klassische Performance-Fallen lauern.
Dieser Artikel geht über einfache "Index hinzufügen"-Tipps hinaus. Es geht um die B-Tree-Mechanik hinter Indizes, um die Kosten-Nutzen-Abwägung bei Writes, um konkrete EXPLAIN-Analysen und um die Fallen, die selbst erfahrene Teams regelmäßig in Produktion ausbremsen.
Inhaltsverzeichnis
Key Takeaways
- Indizes basieren auf B-Tree-Strukturen und beschleunigen Lesezugriffe, verlangsamen aber jeden INSERT, UPDATE und DELETE messbar.
- Hohe Kardinalität (viele unterschiedliche Werte) macht Indizes wertvoll, niedrige Kardinalität (z. B. Boolean-Spalten) macht sie oft nutzlos oder sogar kontraproduktiv.
- EXPLAIN und EXPLAIN ANALYZE zeigen exakt, ob MySQL einen Index nutzt, einen Full-Table-Scan durchführt oder teuer sortiert.
- Das N+1-Problem, fehlende JOIN-Indizes und SELECT * sind die drei häufigsten Performance-Killer in ORM-basierten Anwendungen.
- Connection Pooling und mehrstufiges Caching (Redis, Application-Level) entlasten die Datenbank, bevor überhaupt eine Query ankommt.
Wie Indizes technisch funktionieren: Die B-Tree-Struktur im Detail
Ein MySQL-Index ist im Kern ein sortierter B-Baum (B-Tree). Statt jede Zeile einer Tabelle sequenziell zu durchsuchen, navigiert die Datenbank durch mehrere Ebenen von Knoten, Wurzelknoten, Verzweigungsknoten und Blattknoten, und reduziert dabei die Suchkomplexität von O(n) auf O(log n).
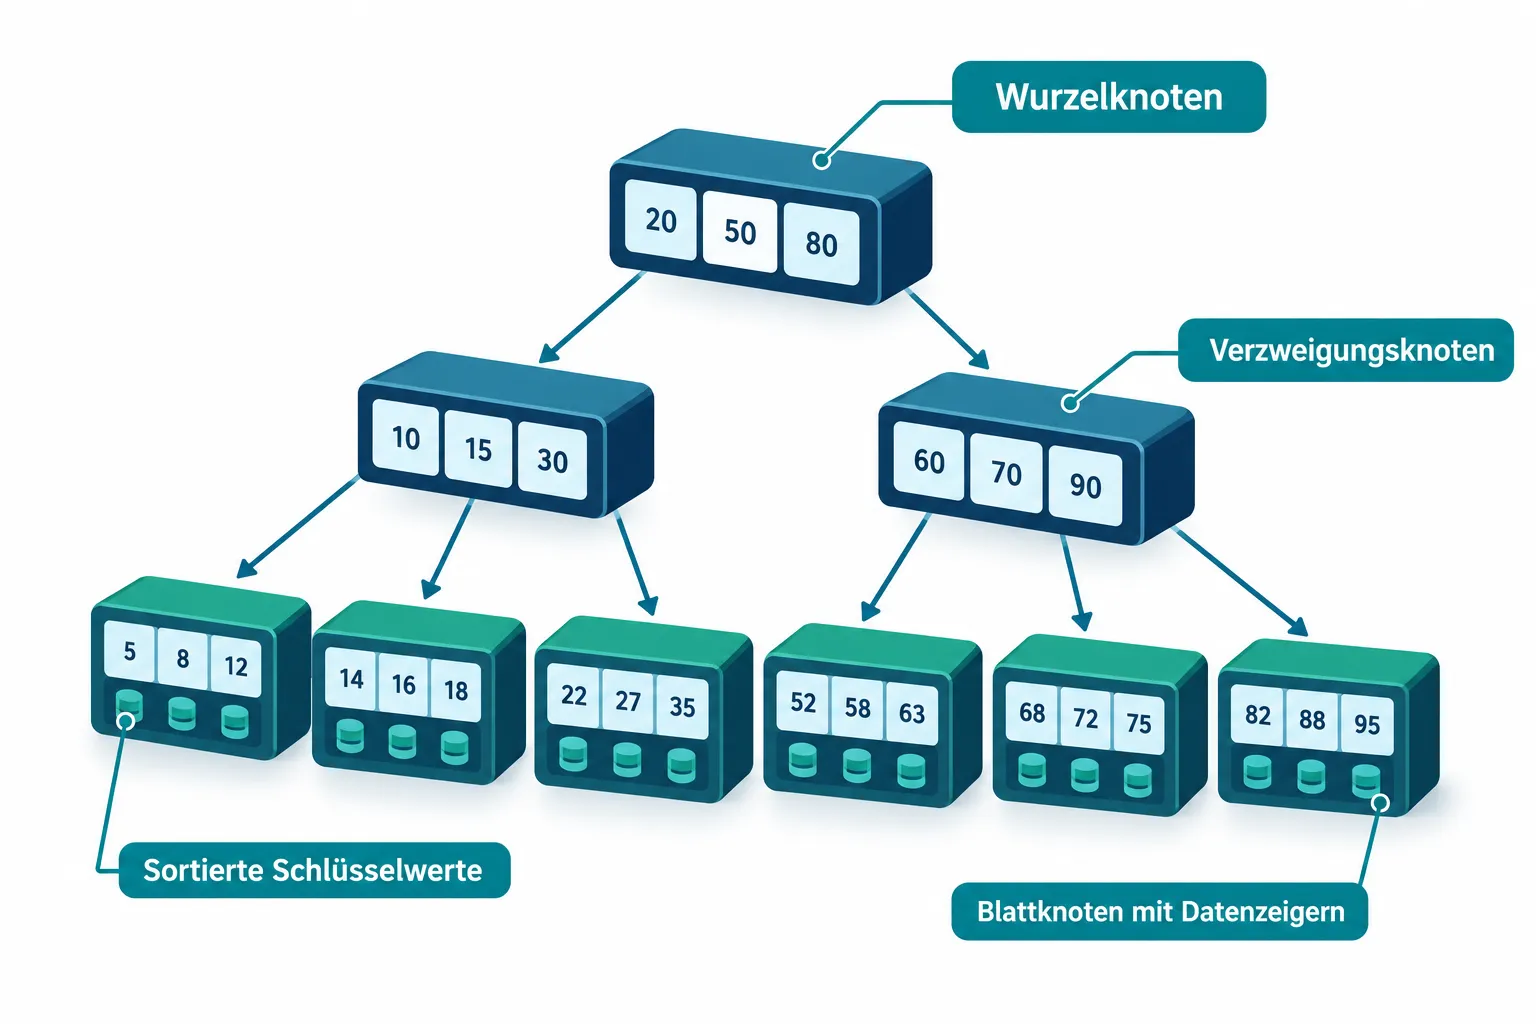
Bei InnoDB, der Standard-Storage-Engine, ist der Primärschlüssel-Index gleichzeitig der Clustered Index: Die eigentlichen Datenzeilen liegen physisch sortiert nach dem Primärschlüssel vor. Sekundäre Indizes speichern in ihren Blattknoten dagegen nur den Indexwert plus einen Verweis auf den Primärschlüssel. Das bedeutet: Nutzt eine Query einen sekundären Index, aber benötigt zusätzliche Spalten, folgt ein zweiter Lookup im Clustered Index, ein sogenannter "Bookmark Lookup".
Genau hier setzt das Konzept des Covering Index an: Ein Index, der alle in SELECT, WHERE und ORDER BY benötigten Spalten bereits enthält, macht diesen zweiten Lookup überflüssig. Das MySQL-Referenzhandbuch empfiehlt für fortgeschrittenes Tuning explizit, Index-Selektivität und Abdeckungsgrad zu prüfen, statt einfach reflexartig weitere Indizes anzulegen [1][2].
-- Covering Index für eine häufige Filterabfrage
CREATE INDEX idx_orders_covering
  ON orders (customer_id, status, created_at, total_amount);
Wann Indizes bei der Datenbank Performance Optimierung helfen, und wann sie schaden
Nicht jede Spalte profitiert von einem Index. Die entscheidende Kennzahl ist die Kardinalität, die Anzahl unterschiedlicher Werte im Verhältnis zur Zeilenanzahl.
| Szenario | Index sinnvoll? | Begründung |
|---|---|---|
| E-Mail-Adresse (hohe Kardinalität) | Ja | Fast jeder Wert ist einzigartig, hohe Selektivität |
| Status-Spalte mit 3 Werten (niedrige Kardinalität) | Selten | Optimizer scannt oft trotzdem, Index bringt kaum Vorteil |
| Tabelle mit unter 1.000 Zeilen | Meist nein | Full-Table-Scan ist oft schneller als Index-Lookup |
| Spalte mit sehr vielen Writes (z. B. Log-Timestamp bei hoher Schreiblast) | Abwägen | Jeder Write muss den B-Tree neu balancieren |
| JOIN-Spalten (Foreign Keys) | Ja, fast immer | Ohne Index entsteht ein teurer verschachtelter Scan |
Der Punkt "Writes" wird oft unterschätzt: Jeder zusätzliche Index muss bei INSERT, UPDATE und DELETE mitgepflegt werden. Auf einer Tabelle mit zehn Sekundärindizes kostet ein einzelner INSERT plötzlich zehn zusätzliche B-Tree-Aktualisierungen. Bei schreiblastigen Systemen, etwa Event-Logging oder IoT-Datenströme, kann das die Datenbank Performance Optimierung ins Gegenteil verkehren.
Ein weiterer Fallstrick: Funktionen auf indexierten Spalten verhindern die Indexnutzung komplett. WHERE YEAR(created_at) = 2026 kann den Index auf created_at nicht nutzen, weil MySQL für jede Zeile erst die Funktion auswerten muss, bevor ein Vergleich möglich ist [5]. Die Lösung ist ein Bereichsvergleich:
-- Schlecht: verhindert Indexnutzung
SELECT * FROM orders WHERE YEAR(created_at) = 2026;

-- Gut: nutzt den Index auf created_at
SELECT * FROM orders
WHERE created_at >= '2026-01-01' AND created_at < '2027-01-01';
Seit MySQL 8.4 unterstützt der Optimizer zudem automatische Histogram-Updates, die die Kardinalitätsabschätzung bei komplexen Queries mit mehreren möglichen Indexpfaden deutlich verbessern [4]. Veraltete Statistiken lassen sich mit ANALYZE TABLE tabellenname; manuell neu berechnen, ein wichtiger Schritt, wenn EXPLAIN stark abweichende Zeilenschätzungen liefert. Auf der Anwendungsseite lohnt sich zudem ein Blick auf aktuelle Backend-Entwicklungen, etwa im Artikel PHP 8.5 Laravel 2026, der auch neue Concurrency-Werkzeuge für datenbanklastige Anwendungen beschreibt.
EXPLAIN und Query-Analyse in MySQL: Der Fahrplan für Datenbank Performance Optimierung
EXPLAIN ist der wichtigste Werkzeug für jede ernsthafte Datenbank Performance Optimierung. Es zeigt, wie MySQL eine Query tatsächlich ausführt, Zugriffsmethode, genutzten Index, geschätzte Zeilenanzahl und mögliche Zusatzoperationen [12][14].
EXPLAIN SELECT o.id, o.total_amount, c.name
FROM orders o
JOIN customers c ON c.id = o.customer_id
WHERE o.status = 'shipped'
ORDER BY o.created_at DESC
LIMIT 20;
Wichtige Spalten in der Ausgabe:
- type:
ALLbedeutet Full-Table-Scan (schlecht),rangeoderrefbedeuten Indexnutzung,eq_refundconstsind ideal. - rows: geschätzte Anzahl durchsuchter Zeilen, je niedriger, desto besser.
- Extra: Hinweise wie "Using filesort" (fehlender Sortier-Index) oder "Using temporary" (fehlender GROUP-BY-Index).
Ab MySQL 8.0.18 liefert EXPLAIN ANALYZE zusätzlich reale Laufzeiten statt reiner Schätzungen, ein entscheidender Unterschied, wenn Statistiken veraltet sind [9][13][14]:
EXPLAIN ANALYZE SELECT o.id FROM orders o WHERE o.customer_id = 4821;
Praxis-Checkliste basierend auf typischen EXPLAIN-Signalen [8][14]:
type = ALLauf WHERE- oder JOIN-Spalten → fehlender Index.Extra: Using filesort→ ORDER-BY-Spalte in den Index aufnehmen.Extra: Using temporary→ GROUP-BY-Spalte indexieren.- Große Differenz zwischen geschätzten und tatsächlichen Zeilen →
ANALYZE TABLEausführen.
Mehrspalten-Indizes sollten dabei bewusst designt werden: zuerst Gleichheitsprädikate, dann Range- oder Sortierspalten, optional gefolgt von reinen SELECT-Spalten für einen Covering Index [8][9][13][14]. Ein korrekt aufgebauter Index kann außerdem die Zahl teurer Datei-Sorts reduzieren, wie auch aktuelle Optimizer-Verbesserungen bei Reverse-Index-Range-Scans zeigen [3].
-- Mehrspalten-Index passend zur Query oben
CREATE INDEX idx_orders_status_created
  ON orders (status, created_at, customer_id);
Index-Hints wie FORCE INDEX oder IGNORE INDEX sind gelegentlich hilfreich, sollten aber nach jedem MySQL-Upgrade neu überprüft werden, da sich der Optimizer stetig verbessert und alte Hints kontraproduktiv werden können [7]. Bei OR-Bedingungen über mehrere Indizes lässt sich über Switchable Optimizations gezielt testen, ob Index-Merge die Laufzeit verbessert [10].
Häufige Performance-Fallen in der Praxis
Das N+1-Problem
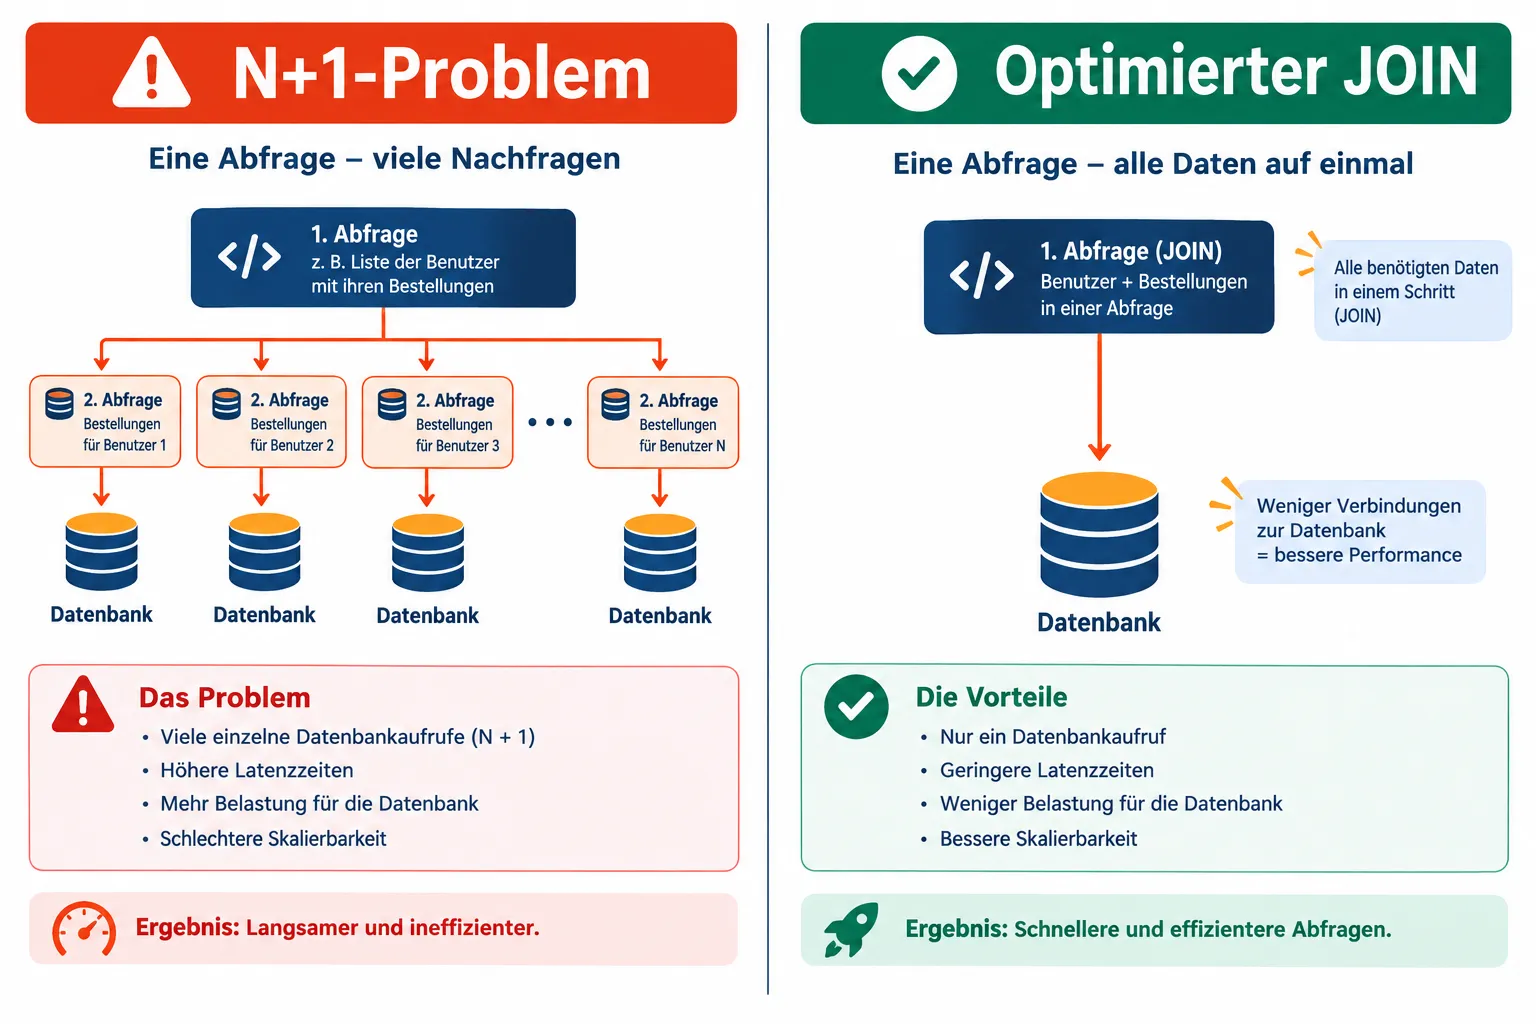
Das N+1-Problem entsteht meist unbemerkt durch ORMs. Ein Beispiel mit einem typischen Node.js-ORM:
// N+1-Problem: 1 Query für Orders + N Queries für jeden Kunden
const orders = await Order.findAll();
for (const order of orders) {
  const customer = await Customer.findByPk(order.customerId); // läuft N-mal!
}
Bei 500 Bestellungen entstehen so 501 separate Datenbankaufrufe statt einem einzigen JOIN. Die Lösung ist Eager Loading:
// Eine einzige Query mit JOIN statt 501 Einzelabfragen
const orders = await Order.findAll({
  include: [{ model: Customer, attributes: ['id', 'name'] }]
});
Fehlende Indizes bei JOINs
JOIN-Spalten ohne Index zwingen MySQL zu verschachtelten Scans über beide Tabellen. Foreign-Key-Spalten sollten daher fast immer indexiert werden:
CREATE INDEX idx_orders_customer_id ON orders (customer_id);
SELECT * vermeiden
SELECT * lädt oft unnötige Spalten, verhindert Covering Indexes und erhöht Netzwerklast und Speicherverbrauch. Explizite Spaltenlisten sind Standard für sauberes Query-Tuning:
-- Statt SELECT * FROM orders WHERE customer_id = 4821;
SELECT id, status, total_amount, created_at
FROM orders
WHERE customer_id = 4821;
Auch beim Paging lohnt sich ein Umdenken: OFFSET-basiertes Paging (LIMIT 20 OFFSET 10000) wird bei großen Tabellen zunehmend langsam, weil MySQL alle übersprungenen Zeilen trotzdem lesen muss. Keyset-Pagination über eine indexierte ID- oder Timestamp-Spalte ist deutlich effizienter [8][14]:
-- Keyset-Pagination statt OFFSET
SELECT id, status, created_at
FROM orders
WHERE created_at < '2026-06-01 12:00:00'
ORDER BY created_at DESC
LIMIT 20;
Connection Pooling: Konzept und Best Practices
Jede neue Datenbankverbindung kostet TCP-Handshake, Authentifizierung und Speicheraufbau, typischerweise mehrere Millisekunden. Bei hoher Request-Frequenz summiert sich das schnell zu spürbarer Latenz. Connection Pooling löst dieses Problem, indem eine begrenzte Anzahl offener Verbindungen wiederverwendet wird, statt für jede Anfrage eine neue zu öffnen.
Best Practices für Connection Pooling:
- Pool-Größe begrenzen: Zu große Pools überlasten den Datenbankserver, zu kleine erzeugen Wartezeiten. Als Startwert eignet sich oft die Anzahl der CPU-Kerne mal 2 bis 4.
- Timeouts konfigurieren: Idle-Verbindungen sollten nach definierter Zeit geschlossen werden, um Ressourcenlecks zu vermeiden.
- Health-Checks aktivieren: Der Pool sollte tote Verbindungen automatisch erkennen und ersetzen.
- Pro Anwendungsinstanz einen eigenen Pool: Mehrere Instanzen mit eigenen Pools verhindern, dass eine überlastete Instanz die anderen blockiert.
// Beispiel: MySQL2-Connection-Pool in Node.js
const pool = mysql.createPool({
  host: 'localhost',
  user: 'app_user',
  connectionLimit: 20,
  idleTimeout: 60000
});
Caching-Strategien für nachhaltige Datenbank Performance Optimierung
Die beste Query ist die, die niemals bei der Datenbank ankommt. Caching auf mehreren Ebenen reduziert die Last dauerhaft:
| Caching-Ebene | Einsatzzweck | Typische Gültigkeitsdauer |
|---|---|---|
| Redis (Key-Value) | Häufig gelesene, selten geänderte Daten (z. B. Produktkataloge) | Sekunden bis Stunden |
| Application-Level-Cache | Berechnete Ergebnisse, Session-Daten im Prozessspeicher | Millisekunden bis Minuten |
| Query-Ergebnis-Cache (extern) | Vollständige Query-Resultate für identische Parameter | Minuten bis Stunden |
Ein typisches Muster kombiniert Redis mit einem Cache-Aside-Ansatz:
async function getCustomer(id) {
  const cached = await redis.get(`customer:${id}`);
  if (cached) return JSON.parse(cached);

  const customer = await db.query(
    'SELECT id, name, email FROM customers WHERE id = ?', [id]
  );
  await redis.set(`customer:${id}`, JSON.stringify(customer), 'EX', 300);
  return customer;
}
Wichtig ist eine klare Invalidierungsstrategie: Bei jedem UPDATE oder DELETE der zugrunde liegenden Daten muss der entsprechende Cache-Eintrag gezielt gelöscht werden, sonst entstehen veraltete Antworten.
Fazit und nächste Schritte
Nachhaltige Datenbank Performance Optimierung entsteht nicht durch pauschale Regeln, sondern durch systematisches Messen. B-Tree-Indizes beschleunigen selektive Lesezugriffe erheblich, kosten aber bei jedem Write. EXPLAIN und EXPLAIN ANALYZE liefern die objektive Grundlage, um Indexnutzung, Join-Reihenfolge und Sortieroperationen zu bewerten, statt auf Bauchgefühl zu vertrauen. Klassiker wie das N+1-Problem, fehlende JOIN-Indizes und SELECT * lassen sich mit den gezeigten Mustern gezielt beheben.
Als konkreten nächsten Schritt empfiehlt sich: die drei langsamsten Queries der eigenen Anwendung mit EXPLAIN ANALYZE zu prüfen, unbenutzte Indizes über sys-Views wie sys.schema_unused_indexes zu identifizieren, und anschließend Connection Pooling sowie eine Redis-Caching-Schicht dort einzuführen, wo Lesezugriffe dominieren. Wer diese drei Hebel konsequent kombiniert, reduziert Antwortzeiten oft um eine Größenordnung, ohne einen einzigen Server hinzuzufügen.
References
[1] Optimization Indexes – https://dev.mysql.com/doc/refman/8.4/en/optimization-indexes.html [2] Optimization – https://dev.mysql.com/doc/refman/8.4/en/optimization.html [3] News 8 4 11 – https://dev.mysql.com/doc/relnotes/mysql/8.4/en/news-8-4-11.html [4] Mysql 8.4 Relnotes En – https://downloads.mysql.com/docs/mysql-8.4-relnotes-en.pdf [5] Where Optimization – https://dev.mysql.com/doc/refman/8.4/en/where-optimization.html [7] Introduction To Mysql Query Tuning For Devops – https://downloads.mysql.com/events/mysql-global-forum/Introduction_to_MySQL_Query_Tuning_for_Devops.pdf [8] Database Mysql Explain Query Optimization – https://pkglog.com/en/blog/database-mysql-explain-query-optimization/ [9] How To Query Tune In Mysql – https://www.getgalaxy.io/learn/glossary/how-to-query-tune-in-mysql [10] Switchable Optimizations – https://dev.mysql.com/doc/refman/8.4/en/switchable-optimizations.html [12] Optimizing Queries with EXPLAIN – https://dev.mysql.com/doc/refman/8.4/en/using-explain.html [13] How To Query Tune In Mysql – https://www.getgalaxy.io/learn/glossary/how-to-query-tune-in-mysql [14] Database Mysql Explain Query Optimization – https://pkglog.com/en/blog/database-mysql-explain-query-optimization/
Häufige Fragen
Warum kann ein fehlender Index eine Query drastisch verlangsamen?
Ohne Index muss MySQL alle Zeilen sequenziell durchsuchen (O(n)), während ein B-Tree-Index die Suche auf O(log n) reduziert – das kann den Unterschied zwischen 2 Millisekunden und 8 Sekunden ausmachen.
Wann schadet ein zusätzlicher Index mehr, als er nutzt?
Bei niedriger Kardinalität (z. B. Boolean-Spalten), kleinen Tabellen unter 1.000 Zeilen oder stark schreiblastigen Tabellen, weil jeder INSERT, UPDATE und DELETE den Index mitpflegen muss.
Wofür wird EXPLAIN in MySQL genutzt?
EXPLAIN zeigt, ob eine Query einen Index nutzt, einen Full-Table-Scan durchführt oder teuer sortiert; EXPLAIN ANALYZE liefert zusätzlich reale statt geschätzte Laufzeiten.
Was ist das N+1-Problem und wie löst man es?
Es entsteht, wenn ein ORM für jede Zeile einer Ergebnisliste eine zusätzliche Einzelabfrage ausführt statt eines JOINs; die Lösung ist Eager Loading, bei dem alle Daten in einer einzigen Query geladen werden.