Ein Wert zwischen 70 und 500 Millisekunden gegen bis zu 329 Sekunden bei führenden Frontier-Modellen: Diese Zahl ist der Kern, um den sich dieser Artikel dreht. Wer Jev bereits aus Teil 1 dieser Serie kennt, weiß, dass es sich um ein sogenanntes System-One-Modell handelt, ein entscheidungsbasiertes Modell statt eines textgenerierenden. In diesem zweiten Teil geht es darum, was unter der Haube passiert, warum die Jev AI Performance in bestimmten Aufgabenklassen so drastisch von klassischen LLMs abweicht und wo die technischen Grenzen des Systems liegen.
Dieser Artikel ist Teil 2 einer dreiteiligen Serie zu Jev AI (TypeSafe AI). Teil 1 hat die Grundidee erklärt, Teil 3 wird sich mit konkreten Einsatzszenarien beschäftigen, Teil 4 stellt zehn reale Community-Projekte vor. Hier liegt der Fokus auf Architektur, Benchmarks und den harten technischen Limits, die Entwickler kennen müssen, bevor sie Jev in eine Produktionsumgebung integrieren.
Inhaltsverzeichnis
Key Takeaways
- Jev arbeitet mit drei Frage-Primitiven, Choice, Score und Noul, die strukturierte, kalibrierte Wahrscheinlichkeiten statt freien Text liefern.
- Die Jev AI Performance liegt bei End-to-End-Antwortzeiten von 70 bis 500 Millisekunden, gegenüber 3 bis 329 Sekunden bei vergleichbaren Frontier-LLMs.
- Architektonisch generiert Jev alle Wahrscheinlichkeiten parallel statt Token-für-Token, dadurch entfällt die klassische Halluzinationsgefahr.
- Technische Grenzen bestehen vor allem beim Kontextfenster (64.000 Token gesamt), bei der Eingabemodalität (nur Text) und bei Rate-Limits (250.000 Token/Sekunde, 1.200 Requests/Minute).
- Jev ersetzt keine generativen Modelle wie GPT, Claude oder Gemini, sondern ergänzt sie als schneller Entscheidungs-Layer in Agent-Architekturen.
Die drei Frage-Primitive: Choice, Score und Noul
Jev beantwortet keine offenen Fragen mit frei generiertem Text. Stattdessen arbeitet das Modell mit drei fest definierten Primitiven, die jeweils einen typsicheren, strukturierten Ausgabewert liefern [7][8].
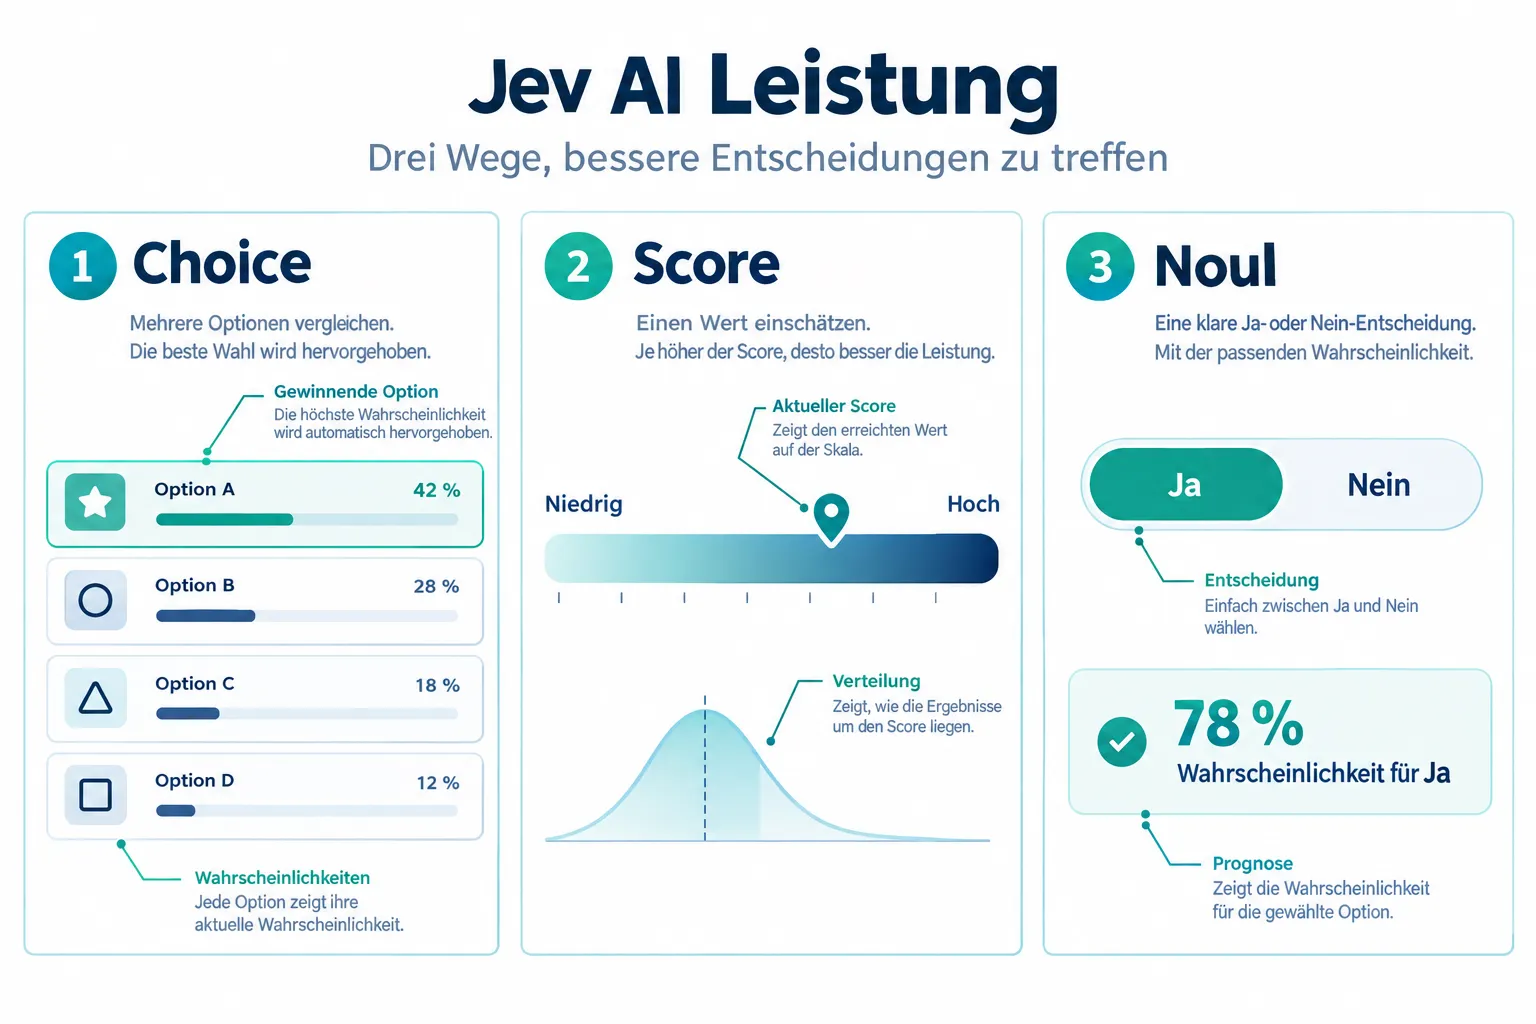
- Choice wählt eine Option aus einer vom Aufrufer definierten Menge aus. Die Antwort enthält Wahrscheinlichkeiten für jede einzelne Option plus einen Gesamt-Konfidenzwert.
- Score bewertet den übergebenen State gegen eine geordnete Skala, etwa niedrig/mittel/hoch. Die Ausgabe umfasst einen kontinuierlichen Score, eine vollständige Verteilung über die Stufen und einen Konfidenzwert.
- Noul beantwortet eine reine Ja/Nein-Frage und liefert eine Wahrscheinlichkeit zwischen 0 und 1, dass eine bestimmte Aussage wahr ist.
Besonders relevant für die Praxis: Mehrere Fragen lassen sich in einer einzigen Anfrage parallel gegen denselben State stellen. Da Jev alle Antworten in einem Durchgang generiert und nicht sequenziell Token für Token, ändert sich die Antwortzeit dabei kaum, ob eine oder zehn Fragen gestellt werden, bleibt für die Latenz nahezu irrelevant [1][7]. Das unterscheidet die Architektur fundamental von klassischen LLM-Aufrufen, bei denen jede zusätzliche Frage zusätzliche Generierungsschritte und damit zusätzliche Zeit bedeutet.
Jev AI Performance im Vergleich zu klassischen LLMs
Der auffälligste Unterschied zwischen Jev und generativen Frontier-Modellen zeigt sich in der Antwortzeit. Laut TypeSafe liegt die End-to-End-Antwortzeit von Jev zwischen 70 und 500 Millisekunden [1][5]. Führende Frontier-LLMs benötigen für vergleichbare Aufgaben, etwa Klassifikation, Risikobewertung oder Routing-Entscheidungen, zwischen 3 und 329 Sekunden [4][5].
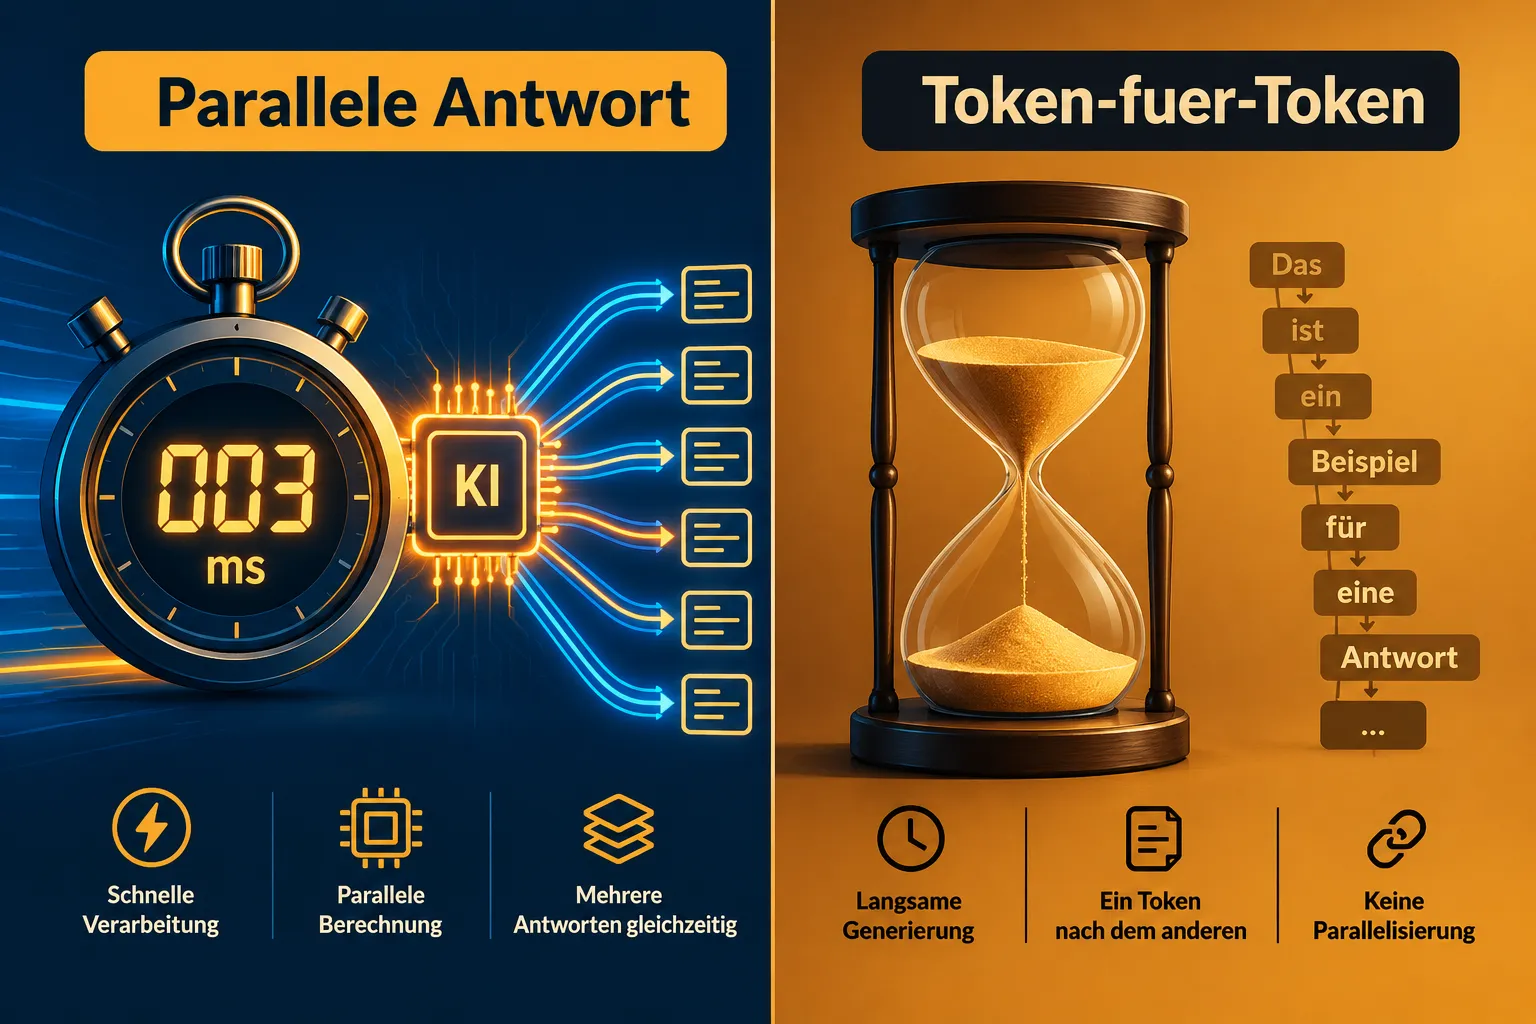
TypeSafe selbst positioniert die Jev AI Performance bei "System-One-typischen" Aufgaben mit einem Faktor von 40x bis 200x gegenüber vergleichbar intelligenten generativen Modellen [1][5]. Diese Zahl bezieht sich explizit auf Aufgaben, die klar begrenzt sind: eine Entscheidung, eine Kategorie, eine Wahrscheinlichkeit, nicht auf offene, kreative Textgenerierung.
| Kriterium | Jev | Vergleichbare Frontier-LLMs |
|---|---|---|
| Antwortzeit | 70-500 ms | 3-329 s |
| Generierungsmodus | Parallel, alle Werte gleichzeitig | Sequenziell, Token für Token |
| Mehrfachfragen pro Request | Kaum Zeitverlust | Zusätzliche Zeit pro Frage |
| Ausgabeform | Typsichere strukturierte Werte | Freier Text |
"Bei System-One-typischen Aufgaben ist Jev 40x bis 200x schneller, bei vergleichbarem Intelligenzniveau."
Diese Größenordnung erklärt, warum TypeSafe Jev nicht als weiteres allgemeines Sprachmodell vermarktet, sondern als spezialisierte Antwort auf ein konkretes Performance-Problem in Agent-Systemen, in denen viele kleine Entscheidungen pro Sekunde anfallen [2][6].
Technische Grenzen von Jev
Trotz der Geschwindigkeitsvorteile ist Jev kein Allzweckwerkzeug. Wer die Jev AI Performance realistisch einschätzen will, muss die aktuellen technischen Limits kennen [7][8]:
- Kontextfenster: Insgesamt stehen 64.000 Token zur Verfügung, das schließt den State und alle Fragen einer Anfrage ein. Davon dürfen maximal 32.000 Token auf den State plus die längste einzelne Frage entfallen.
- Nur Text-Eingabe: Jev verarbeitet ausschließlich Text. Bilder, Audio oder Video können nicht direkt übergeben werden, sondern müssten vorher in Textform umgewandelt werden.
- Trainingssprache: Die primäre Trainingssprache ist Englisch. Für andere Sprachen ist mit potenziell geringerer Kalibrierungsqualität zu rechnen.
- Rate-Limits: Die API begrenzt Anfragen auf 250.000 Token pro Sekunde und 1.200 Requests pro Minute.
Diese Limits sind für die Zielaufgaben von Jev, kurze, klar umrissene Entscheidungen, in der Regel unkritisch. Problematisch werden sie erst, wenn Entwickler versuchen, sehr lange Dokumente vollständig in den State zu packen oder Jev für Aufgaben einzusetzen, die eigentlich multimodale Eingaben erfordern. Für solche Fälle bleibt weiterhin ein generatives Modell die richtige Wahl [7][8].
Architektur: Warum Jev nicht halluziniert
Der zentrale architektonische Unterschied zu klassischen LLMs liegt im Generierungsprozess selbst. Klassische autoregressive Modelle erzeugen Text Token für Token, wobei jedes neue Token von allen vorherigen abhängt. Jev hingegen basiert auf einem nicht-autoregressiven, parallelen Sampler: Alle Wahrscheinlichkeiten für eine Antwort werden in einem einzigen Durchgang gleichzeitig berechnet, nicht sequenziell [1][6].
Diese Architektur hat eine wichtige Konsequenz für die Zuverlässigkeit. Weil der Ausgabetyp und die möglichen Werte, also die Optionen bei Choice, die Skala bei Score oder die Ja/Nein-Frage bei Noul, bereits vor der Generierung feststehen, kann Jev keine Werte außerhalb dieses definierten Raums erzeugen. Es gibt keine freie Textgenerierung, in der ein Modell plausibel klingende, aber falsche Fakten erfinden könnte. Damit entfällt strukturell die Möglichkeit zu halluzinieren, wie sie bei generativen Modellen auftreten kann [1][10].
Trainiert wird Jev nicht mit den bei generativen Modellen üblichen Verfahren wie RLHF (Reinforcement Learning from Human Feedback) oder RLVR (Reinforcement Learning with Verifiable Rewards), sondern mit einem eigenen Ansatz namens Reinforcement Learning for Calibrated Decisions (RLCD) [1][6]. Während RLHF vor allem auf Textqualität und menschliche Präferenzen optimiert, zielt RLCD auf kalibrierte Wahrscheinlichkeits-Ehrlichkeit ab: Ein Konfidenzwert von 80 Prozent soll tatsächlich bedeuten, dass die Antwort in etwa 80 von 100 vergleichbaren Fällen korrekt ist. Diese Kalibrierung ist die Grundlage dafür, dass Entwickler Schwellenwerte und Risikoabschätzungen auf den Wahrscheinlichkeiten von Jev aufbauen können.
Preis und Kosten-Performance
Neben der Geschwindigkeit ist der Preis der zweite große Hebel, den TypeSafe für Jev hervorhebt. Für Input-Token berechnet TypeSafe 0,042 US-Dollar pro Million Token, Output-Token sind kostenlos [1][5]. In Kombination mit der Geschwindigkeit ergibt sich laut TypeSafe ein Kostenvorteil von bis zu 400x gegenüber vergleichbaren LLMs bei Klassifikationsaufgaben [1][4].
Dieser Kostenvorteil entsteht aus zwei Effekten gleichzeitig: Erstens fallen für Output keine Kosten an, da die Ausgabe aus kompakten strukturierten Werten statt aus langen Textblöcken besteht. Zweitens sinkt durch die parallele Verarbeitung mehrerer Fragen in einem Request der Overhead pro einzelner Entscheidung deutlich. Für Systeme, die pro Sekunde Hunderte oder Tausende Klassifikations- oder Routing-Entscheidungen treffen müssen, kann dieser Unterschied den Unterschied zwischen wirtschaftlich tragfähigem und unwirtschaftlichem Betrieb ausmachen.
Einordnung: Jev als Entscheidungs-Layer, kein Ersatz für generative Modelle
Ein Missverständnis, das sich bei der Bewertung der Jev AI Performance vermeiden lässt, ist die Annahme, Jev trete in direkte Konkurrenz zu Modellen wie GPT, Claude oder Gemini. Das ist explizit nicht der Fall [2][9]. Jev ist kein generatives Modell und kann keine langen Texte schreiben, keinen Code generieren und keine offenen kreativen Aufgaben lösen.
Stattdessen positioniert sich Jev als komplementärer Entscheidungs-Layer, der neben einem generativen Hauptmodell in einer Agent-Architektur läuft [2][6]:
- Das generative Modell plant Abläufe, schreibt Text oder Code und übernimmt offene, kreative Aufgaben.
- Jev übernimmt die häufigen, eng begrenzten Zwischenentscheidungen, etwa Klassifikation eingehender Anfragen, Routing zwischen verschiedenen Agenten-Pfaden oder Risikoprüfung einzelner Schritte.
In einer solchen Architektur läuft Jev oft mehrfach pro Sekunde im Hintergrund, während das generative Modell seltener, aber für komplexere Schritte aufgerufen wird. Diese Aufgabenteilung erklärt auch, warum die Größenordnungen bei Geschwindigkeit und Preis so hoch ausfallen: Jev wurde gezielt für eine schmale, aber häufig wiederkehrende Aufgabenklasse trainiert und optimiert, nicht für allgemeine Sprachverarbeitung [3][6].
Fazit
Die Jev AI Performance ist kein Marketingversprechen im luftleeren Raum, sondern das Ergebnis einer bewusst anderen Architekturentscheidung: paralleles statt sequenzielles Generieren, typsichere Ausgaben statt freiem Text, kalibrierte Wahrscheinlichkeiten statt reiner Textqualität. Für Entwickler bedeutet das konkret: Wer in einer Agent-Pipeline viele kleine, klar begrenzte Entscheidungen treffen muss, findet in Jev ein Werkzeug, das Latenz und Kosten drastisch senken kann, innerhalb der genannten Grenzen von Kontextfenster, Eingabemodalität und Rate-Limits.
Der nächste sinnvolle Schritt für technische Teams ist, konkrete Entscheidungspunkte in der eigenen Agent-Architektur zu identifizieren, Klassifikation, Routing, Risikoprüfung, und zu prüfen, ob sich diese als Choice-, Score- oder Noul-Frage formulieren lassen. Teil 3 dieser Serie beleuchtet, wie solche Einsatzszenarien in der Praxis konkret aussehen.
References
[1] Introducing System One Models And Jev – https://typesafe.ai/blog/introducing-system-one-models-and-jev [2] Building A Harness With Jev – https://www.langchain.com/blog/building-a-harness-with-jev [3] Jev System One Model Launch – https://www.mindstudio.ai/blog/jev-system-one-model-launch [4] Typesafe Jev System One Models Release Guide 2026 – https://www.developersdigest.tech/blog/typesafe-jev-system-one-models-release-guide-2026 [5] Typesafe Ai Releases Jev – https://www.marktechpost.com/2026/09/19/typesafe-ai-releases-jev/ [6] System One Models Jev – https://www.datacamp.com/blog/system-one-models-jev [7] Introduction – https://docs.typesafe.ai/introduction [8] What Is Jev – https://apidog.com/blog/what-is-jev/ [9] typesafe.ai – https://typesafe.ai/ [10] Jev Typesafe Ai – https://powerdrill.ai/blog/jev-typesafe-ai
Häufig gestellte Fragen
Wie schnell antwortet Jev AI im Vergleich zu klassischen LLMs?
Die End-to-End-Antwortzeit von Jev liegt zwischen 70 und 500 Millisekunden, während führende Frontier-LLMs für vergleichbare Aufgaben wie Klassifikation, Risikobewertung oder Routing-Entscheidungen zwischen 3 und 329 Sekunden benötigen.
Welche drei Frage-Primitive nutzt Jev?
Jev arbeitet mit drei fest definierten Primitiven: Choice wählt eine Option aus einer definierten Menge mit Wahrscheinlichkeiten je Option, Score bewertet einen State gegen eine geordnete Skala mit kontinuierlichem Score und Verteilung, und Noul beantwortet eine Ja/Nein-Frage mit einer Wahrscheinlichkeit zwischen 0 und 1.
Wo liegen die technischen Grenzen von Jev?
Jev hat ein Kontextfenster von insgesamt 64.000 Token (davon maximal 32.000 Token für State plus die längste Frage), verarbeitet ausschließlich Text (keine Bilder, Audio oder Video), ist primär auf Englisch trainiert und ist auf 250.000 Token pro Sekunde sowie 1.200 Requests pro Minute limitiert.
Warum halluziniert Jev nicht wie generative Modelle?
Jev basiert auf einem nicht-autoregressiven, parallelen Sampler, der alle Wahrscheinlichkeiten in einem Durchgang statt Token für Token berechnet. Da Ausgabetyp und mögliche Werte bereits vor der Generierung feststehen, kann Jev keine Werte außerhalb dieses definierten Raums erzeugen, wodurch die klassische Halluzinationsgefahr freier Textgenerierung strukturell entfällt.
Die Jev-AI-Serie
- Teil 1: Was ist Jev AI? Das neue KI-Modell von TypeSafe erklärt
- Teil 3: Jev AI Use Cases in der Praxis – 5 Beispiele für schnelle KI-Entscheidungen
Dieser Artikel ist Teil der Jev-AI-Serie. Teil 5: Jev AI als LLM-as-a-Judge-Alternative: Die LangChain-Studie zur Agent-Evaluierung.