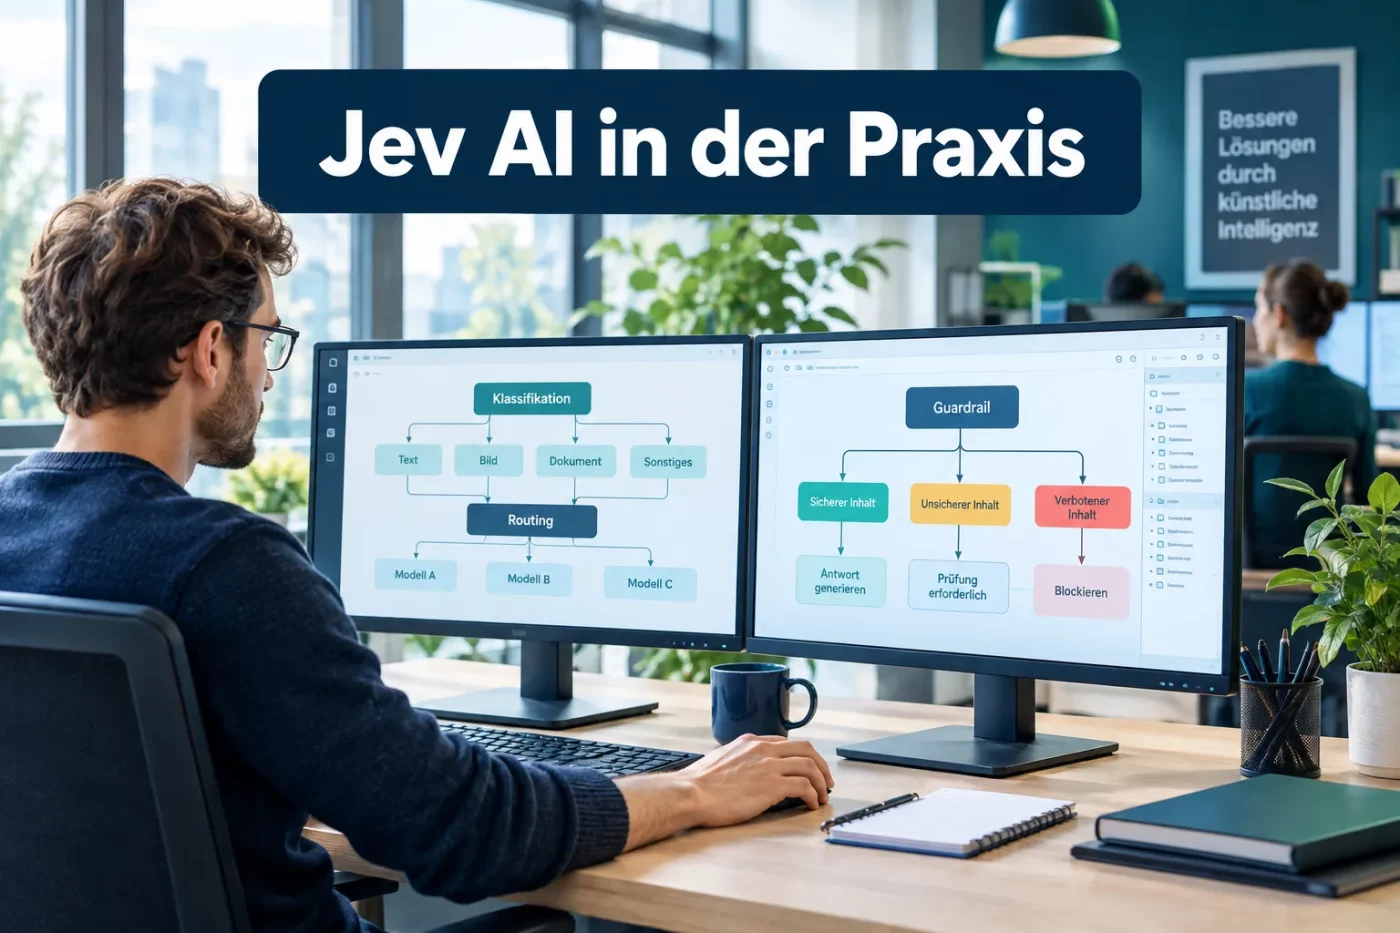
Ein einzelner GPT-4-Chat-Call für eine Ja/Nein-Entscheidung kostet oft mehr Zeit und Geld als die eigentliche Business-Logik dahinter. Genau an diesem Missverhältnis setzt Jev an. Während generative Modelle wie GPT, Claude oder Gemini in Agent-Architekturen für offenes Reasoning zuständig bleiben, übernimmt Jev die Masse der kleinen, eng begrenzten Entscheidungen, die in jeder produktiven Software-Pipeline anfallen. Dieser Artikel zeigt anhand von fünf konkreten Jev AI Use Cases, wie Entwickler diesen strukturierten Entscheidungs-Layer real einsetzen — von Intent-Klassifikation bis Guardrails für Tool-Calls.
Dies ist der dritte Teil einer Serie: Teil 1 hat Jev als Konzept vorgestellt, Teil 2 die Performance- und Architekturfragen beleuchtet. Teil 4 zeigt anschließend zehn konkrete Community-Projekte, die auf Jev AI aufbauen Hier geht es um die Praxis: Wo genau ersetzt Jev einen teuren LLM-Call durch eine schnelle, typsichere Entscheidung — und wo eben nicht.
Inhaltsverzeichnis
Key Takeaways
- Jev AI Use Cases konzentrieren sich auf wiederkehrende, eng begrenzte Entscheidungen: Klassifikation, Routing, Scoring, Extraktion und Guardrail-Checks.
- Die offizielle LangChain-Integration über
TypeSafeClassifiererlaubt es, State und Fragen direkt an.invoke()zu übergeben und strukturierte Ergebnisse statt Chat-Antworten zu erhalten [1][2]. - Model-Routing-Middleware und AutoModeMiddleware sind zwei dokumentierte Muster, bei denen Jev vor der eigentlichen Modell- oder Tool-Ausführung eine Vorentscheidung trifft [1][7].
- Jev ersetzt keine generativen Modelle: Es liefert keine Prosa, keinen Code, keine offenen Erklärungen — nur strukturierte, typsichere Entscheidungen.
- Typsicherheit garantiert das Format der Antwort, nicht deren inhaltliche Richtigkeit. Business-Genauigkeit muss weiterhin mit echten Daten validiert werden [4][5].
Was Jev in Agent-Architekturen konkret leistet
Jev, auch als "TypeSafe AI" bezeichnet, positioniert sich als Entscheidungsmodell-Kategorie neben den generativen Hauptmodellen — nicht als deren Ersatz [3][4]. In einer typischen Agent-Pipeline übernimmt das Hauptmodell Planung, Textgenerierung und komplexes Reasoning, während Jev an klar definierten Punkten eine begrenzte Frage beantwortet: Ist diese Anfrage dringend? Welches Team soll das Ticket bearbeiten? Ist dieser Tool-Call riskant?
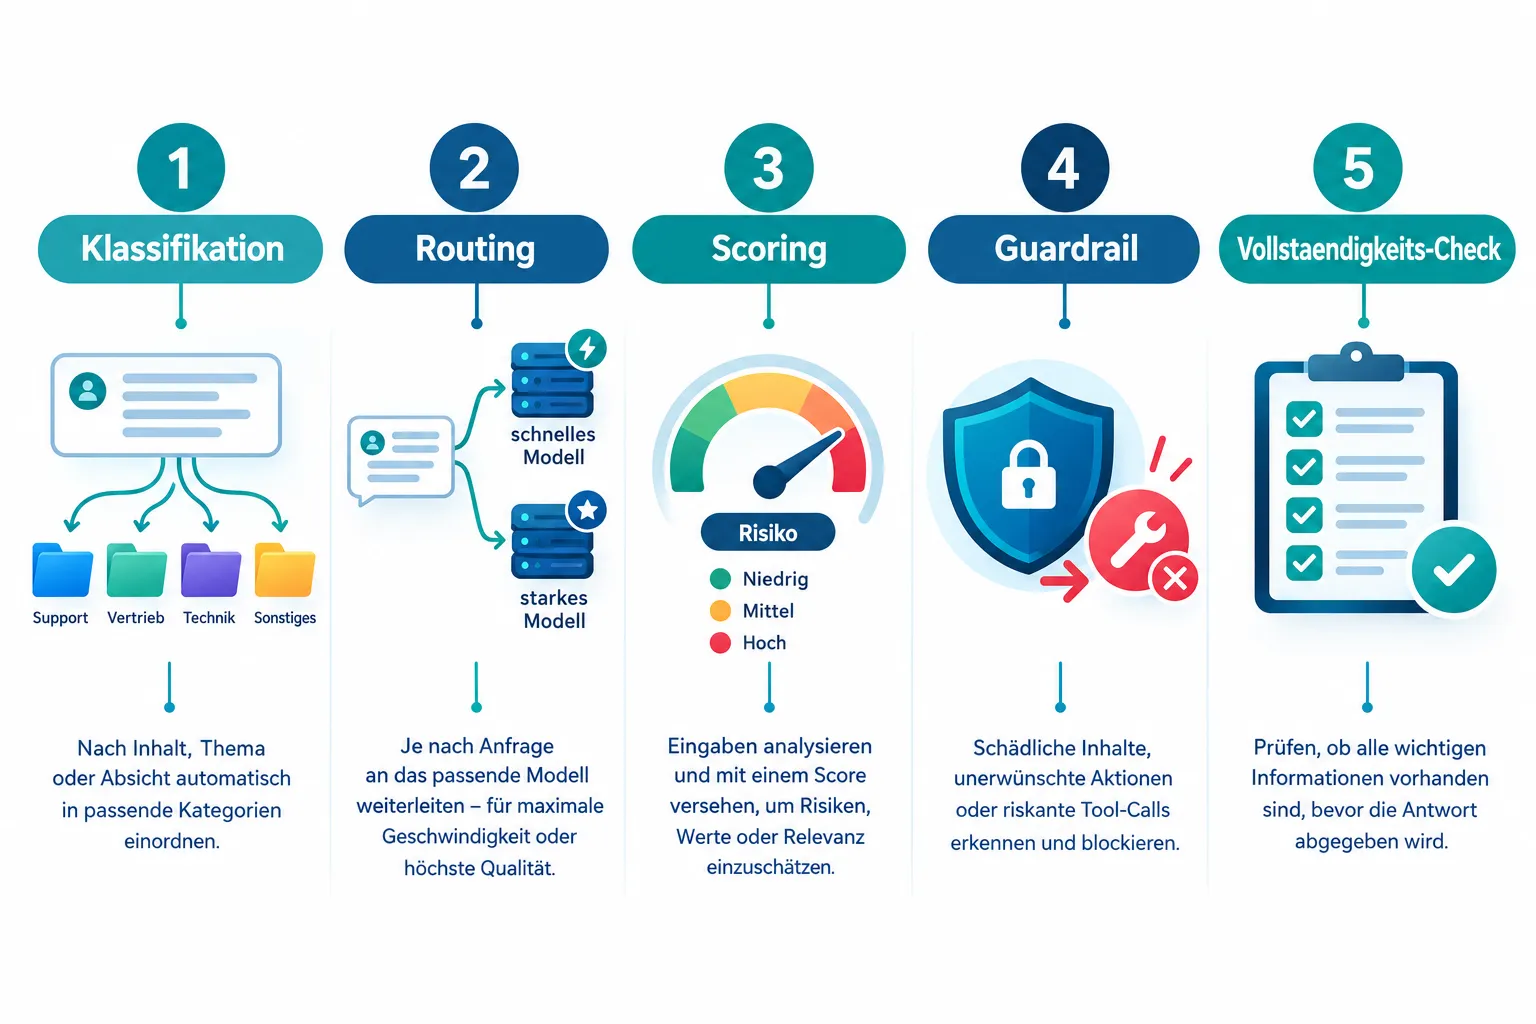
Diese Aufteilung ist der Kern aller Jev AI Use Cases: Jev wird dort eingesetzt, wo handgeschriebene if-Regeln zu starr oder zu brüchig wären, ein voller LLM-Chat-Call aber zu teuer oder zu langsam ist. Das Ergebnis ist eine strukturierte, vorhersehbare Antwort, die sich wie eine gewöhnliche Programmiervariable weiterverarbeiten lässt — daher der Begriff "smart if-statement".
Jev AI Use Cases im Überblick: 5 Muster für schnelle Entscheidungen
Aus der Dokumentation von TypeSafe, der LangChain-Integration und unabhängigen Analysen lassen sich fünf wiederkehrende Anwendungsmuster ableiten, die in produktiven Systemen bereits eingesetzt werden [1][2][6][7].
1. Agent-Routing, Eskalation und Tool-Auswahl in LangChain
Der wohl am besten dokumentierte Anwendungsfall ist Routing innerhalb von LangChain-Agenten. Eine Model-Routing-Middleware nutzt Jev, um anhand der letzten Nutzernachricht zu entscheiden, welches Modell für die Anfrage am besten geeignet ist [1]. Einfache Fragen erhalten ein schnelles, günstiges Modell, komplexe oder mehrdeutige Anfragen werden an ein leistungsfähigeres, teureres Modell weitergeleitet. Diese Entscheidung fällt in Millisekunden, statt dass zuerst ein vollwertiger LLM-Call zur Einschätzung der Komplexität nötig wäre.
Analog lässt sich Jev für Eskalationsentscheidungen einsetzen: Soll eine Anfrage an einen menschlichen Support-Mitarbeiter weitergegeben werden oder kann der Agent sie autonom lösen? Auch die Auswahl des passenden Tools aus einer Werkzeugliste eines Agenten lässt sich als Klassifikationsaufgabe an Jev delegieren [7].
2. Support-Ticket-Triage und Customer-Operations-Automatisierung
Im Kundenservice fallen täglich tausende Anfragen an, die vor der eigentlichen Bearbeitung sortiert werden müssen. Jev kann hier die Intent-Erkennung übernehmen: Handelt es sich um eine Reklamation, eine Rechnungsfrage oder eine technische Störung? Zusätzlich lässt sich die Dringlichkeit scoren — ein Ticket mit den Worten "Server down" bekommt eine höhere Priorität als eine allgemeine Produktfrage.
Diese Kombination aus Klassifikation und Scoring reduziert die Zahl der Fälle, in denen ein teures Sprachmodell nur zur Sortierung aufgerufen werden muss. Stattdessen läuft die Vorsortierung über Jev, und das generative Modell wird erst für die eigentliche, inhaltlich anspruchsvolle Antwort eingesetzt.
3. Moderation, Risikobewertung und Policy-Durchsetzung
Guardrails sind einer der sensibelsten Jev AI Use Cases, weil hier eine Fehlentscheidung direkte Folgen hat. Die dokumentierte AutoModeMiddleware nutzt Jev, um Tool-Calls eines Agenten auf riskante Entscheidungen zu prüfen und den Aufruf zu blockieren, bevor das Tool tatsächlich ausgeführt wird [1]. Ein Agent, der beispielsweise eine Zahlung auslösen oder eine Datei löschen will, wird zuerst durch einen Jev-Check geleitet: Entspricht diese Aktion den definierten Policies?
Auch Content-Moderation fällt in diese Kategorie — etwa die Einschätzung, ob ein Nutzertext gegen Richtlinien verstößt, oder ob eine Kaufabsicht mit hoher Wahrscheinlichkeit vorliegt und ein Angebot ausgelöst werden soll.
4. Log-, Anomalie- und Event-Klassifikation für Reliability Engineering
Systeme im Betrieb erzeugen kontinuierlich Logdaten, Metriken und Events. Ein wiederkehrendes Problem in Site-Reliability-Teams ist die schnelle Einordnung: Ist ein Fehlerereignis kritisch, oder handelt es sich um ein bekanntes, unkritisches Rauschen? Jev kann als Klassifikationsschicht zwischen Monitoring-System und Alerting eingesetzt werden, um Events in Kategorien wie "sofortige Eskalation", "beobachten" oder "ignorieren" einzuordnen — ohne dass jede Alarmmeldung einen vollen LLM-Aufruf auslöst.
5. Agenten-Evaluation und Benchmarking als KI-Richter
Ein spezifisches, in der LangChain-Community diskutiertes Muster ist der Einsatz von Jev als Bewertungsinstanz für andere Agenten — als "AI Judge" [6]. Dabei bewertet Jev strukturiert, ob eine Agenten-Antwort ein definiertes Qualitätskriterium erfüllt, ob eine Aufgabe vollständig abgeschlossen wurde oder ob ein Ergebnis dem erwarteten Format entspricht. Weil diese Bewertung selbst wieder eine begrenzte, wiederholbare Entscheidung ist, eignet sie sich gut für den Jev-Layer statt für einen zusätzlichen teuren Bewertungs-Call durch ein generatives Modell.
Die folgende Übersicht fasst die fünf Muster zusammen:
| Use Case | Typische Frage an Jev | Ersetzt |
|---|---|---|
| Agent-Routing | Welches Modell/Tool passt zur Anfrage? | Manuelle Regeln, teure Vor-Calls |
| Ticket-Triage | Welche Kategorie, welche Dringlichkeit? | Menschliche Erstsortierung |
| Guardrails | Ist dieser Tool-Call riskant? | Fehlende oder starre Sicherheitschecks |
| Log-Klassifikation | Kritisch, beobachten oder ignorieren? | Statische Alert-Schwellenwerte |
| Agent-Evaluation | Erfüllt die Antwort das Kriterium? | Manuelle Review-Stichproben |
Smart If-Statements: Jev AI Use Cases im bestehenden Code integrieren
Der praktische Charme dieser Jev AI Use Cases liegt darin, dass die strukturierten Outputs sich wie gewöhnliche Bedingungen in bestehenden Code einbauen lassen. Statt einer Freitext-Antwort liefert Jev ein definiertes Format — etwa eine Kategorie aus einer festen Liste oder einen numerischen Score — das direkt in einer if– oder switch-Anweisung ausgewertet werden kann.
Der technische Zugriff erfolgt über den Endpoint POST https://api.typesafe.ai/v1/systemone, authentifiziert per Authorization: Bearer-Header [8]. Offizielle Python- und JavaScript-SDKs lesen den API-Key standardmäßig aus der Umgebungsvariable TYPESAFE_API_KEY [8]. Der Workflow folgt dabei einem einfachen Muster: State (der relevante Kontext, etwa eine Nachricht oder strukturierte Daten), Fragen (die konkrete Entscheidung, die getroffen werden soll) und Decisions (das strukturierte Ergebnis) [2][4].
Jev ist zudem über mehrere Plattformen erreichbar, darunter Vercels AI Gateway, Cloudflare, OpenRouter und die TypeSafe-Konsole selbst [8][9]. Auf Vercels AI Gateway gilt Jev laut Berichten als einer der am schnellsten adaptierten Launches der Plattform — ein Signal dafür, dass Entwickler den Bedarf an einer eigenen Entscheidungs-Schicht neben generativen Modellen bereits erkannt haben [9].
LangChain-Integration: TypeSafeClassifier in der Praxis
Für Teams, die bereits mit LangChain arbeiten, ist die offizielle Integration der direkteste Einstiegspunkt in die Jev AI Use Cases. Der TypeSafeClassifier nimmt State und Fragen entgegen und liefert über .invoke() ein Klassifikationsergebnis zurück — keine Chat-Antwort [1][2]. Der State kann dabei reiner Text, strukturierte Daten oder eine Sequenz von LangChain-Nachrichten sein, was die Integration in bestehende Agenten-Graphen erleichtert.
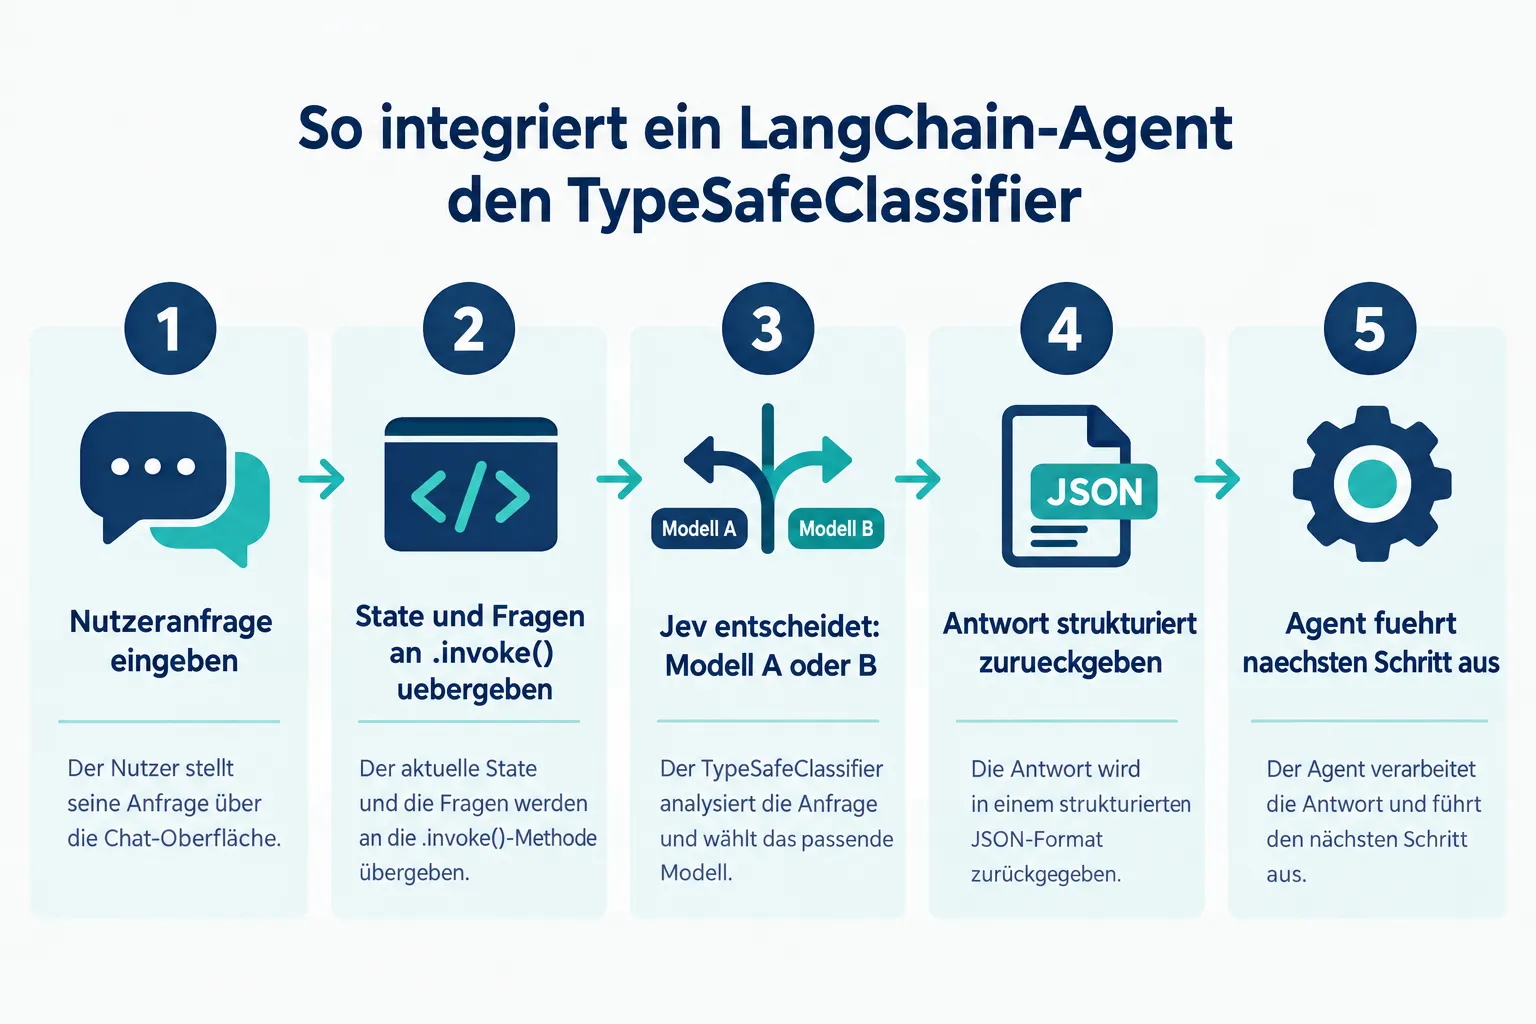
Zwei konkrete Middleware-Muster sind in der LangChain-Dokumentation und begleitenden Analysen beschrieben:
- Model-Routing-Middleware: entscheidet anhand der letzten Nutzernachricht, ob ein schnelles oder ein leistungsfähiges Modell die Anfrage bearbeiten soll [1][7].
- AutoModeMiddleware: prüft Tool-Calls eines Agenten auf riskante Entscheidungen und blockiert die Ausführung, bevor das Tool tatsächlich aufgerufen wird [1].
Beide Muster zeigen denselben Grundgedanken: Jev sitzt als Vorentscheidung vor einem teureren oder riskanteren Schritt und entlastet damit sowohl das Budget als auch die Latenz der Anwendung [3][10].
Grenzen von Jev: Kein Ersatz für generative Modelle
Bei aller praktischen Nähe zu smart if-statements bleibt eine Einschränkung zentral für alle Jev AI Use Cases: Jev ist explizit kein Ersatz für ein generatives Modell. Es kann keine Prosa formulieren, keinen Code generieren und keine offenen Erklärungen liefern [4][5]. Für diese Aufgaben bleibt weiterhin GPT, Claude oder Gemini zuständig.
Ebenso wichtig: Typsicherheit garantiert lediglich, dass die Antwort dem definierten Format entspricht — nicht, dass die inhaltliche Entscheidung korrekt ist [4][5]. Ein Jev-Output kann syntaktisch perfekt und trotzdem fachlich falsch sein, etwa wenn ein Ticket falsch kategorisiert oder ein Risiko unterschätzt wird. Entwickler müssen die Business-Genauigkeit dieser Entscheidungen daher weiterhin mit echten, produktiven Daten validieren — durch Testsets, Monitoring und regelmäßige Stichproben, so wie es für jedes klassifizierende oder scorende System üblich ist.
Diese Grenze ist kein Nachteil des Ansatzes, sondern folgt direkt aus seiner Rolle: Jev ist ein Entscheidungs-Layer für eng begrenzte, wiederkehrende Fragen — kein universelles Sprachmodell.
Fazit und nächste Schritte
Die fünf vorgestellten Jev AI Use Cases — Routing, Ticket-Triage, Guardrails, Log-Klassifikation und Agenten-Evaluation — zeigen ein gemeinsames Muster: Überall dort, wo Software häufig dieselbe Art von begrenzter Entscheidung treffen muss, kann ein strukturierter Layer wie Jev einen vollen LLM-Call durch ein schnelles, typsicheres Ergebnis ersetzen. Die offizielle LangChain-Integration über TypeSafeClassifier macht den Einstieg für Teams, die bereits mit Agenten-Graphen arbeiten, besonders unkompliziert.
Für Entwickler, die AI-Agenten bauen, lohnt sich ein pragmatischer Einstieg: zunächst die eigene Pipeline auf wiederkehrende, klar abgrenzbare Entscheidungspunkte prüfen — Routing, Priorisierung, Sicherheitschecks — und dort testweise einen Jev-Call anstelle eines vollen Chat-Calls einsetzen. Wichtig bleibt dabei, die getroffenen Entscheidungen mit echten Daten zu validieren, statt sich allein auf die formale Typsicherheit zu verlassen. So lässt sich der Entscheidungs-Layer schrittweise dort einbauen, wo er tatsächlich Geschwindigkeit und Kosten spart — ohne die generativen Modelle zu ersetzen, die für offenes Reasoning weiterhin unverzichtbar bleiben.
References
[1] Building A Harness With Jev – https://www.langchain.com/blog/building-a-harness-with-jev [2] Typesafe – https://docs.langchain.com/oss/python/integrations/providers/typesafe [3] Langchain Adds Jev Decision Model Agent Workflows – https://runtimewire.com/article/langchain-adds-jev-decision-model-agent-workflows [4] What Is Jev – https://atomicbot.ai/blog/what-is-jev [5] How To Use Jev – https://aiprofitboardroom.com/blog/how-to-use-jev/ [6] Langchain Jev Agent Evals Benchmark September 2026 – https://www.explainx.ai/blog/langchain-jev-agent-evals-benchmark-september-2026 [7] How To Integrate Jev Agent Routing 2026 – https://explainx.ai/blog/how-to-integrate-jev-agent-routing-2026 [8] typesafe.ai – https://typesafe.ai/ [9] cnblogs – https://www.cnblogs.com/sing1ee/p/23040079 [10] Langchain Adds Jev Classifier To Agent Workflows For Routing And Tool Checks – https://superpowerdaily.com/posts/langchain-adds-jev-classifier-to-agent-workflows-for-routing-and-tool-checks
Häufig gestellte Fragen
Was sind die wichtigsten Jev AI Use Cases in Agent-Architekturen?
Die fünf wiederkehrenden Muster sind Agent-Routing/Eskalation/Tool-Auswahl in LangChain, Support-Ticket-Triage und Customer-Operations, Moderation/Risikobewertung/Policy-Durchsetzung (Guardrails), Log- und Anomalie-Klassifikation für Reliability Engineering sowie Agenten-Evaluation als KI-Richter.
Wie funktioniert die LangChain-Integration mit Jev?
Der offizielle TypeSafeClassifier nimmt State und Fragen entgegen und liefert über .invoke() ein strukturiertes Klassifikationsergebnis statt einer Chat-Antwort. Der State kann reiner Text, strukturierte Daten oder eine Sequenz von LangChain-Nachrichten sein, was die Integration in bestehende Agenten-Graphen erleichtert.
Kann Jev generative Modelle wie GPT, Claude oder Gemini ersetzen?
Nein. Jev kann keine Prosa formulieren, keinen Code generieren und keine offenen Erklärungen liefern. Es ist explizit kein Ersatz für ein generatives Modell, sondern ein ergänzender Entscheidungs-Layer für eng begrenzte, wiederkehrende Fragen wie Klassifikation, Routing oder Risikoprüfung.
Garantiert Typsicherheit, dass Jevs Entscheidungen korrekt sind?
Nein. Typsicherheit garantiert lediglich, dass die Antwort dem definierten Format entspricht, nicht dass die inhaltliche Entscheidung korrekt ist. Ein Jev-Output kann syntaktisch perfekt und trotzdem fachlich falsch sein, weshalb Entwickler die Business-Genauigkeit weiterhin mit echten Produktionsdaten validieren müssen.
Die Jev-AI-Serie
- Teil 1: Was ist Jev AI? Das neue KI-Modell von TypeSafe erklärt
- Teil 2: Jev AI Performance im Detail – Architektur und technische Grenzen
Dieser Artikel ist Teil der Jev-AI-Serie. Teil 5: Jev AI als LLM-as-a-Judge-Alternative: Die LangChain-Studie zur Agent-Evaluierung.