Ende September 2026 tauchte ein neuer Modellname in den Entwickler-Dashboards von Vercel und Novita AI auf: Ling-3.1-flash. Was zunächst wie ein weiteres Update unter vielen aussah, stellt sich bei näherem Hinsehen als eines der größeren Mixture-of-Experts-Modelle dar, die aktuell öffentlich zugänglich sind. Ant Group, über sein Forschungslabor InclusionAI in Hangzhou, hat mit Ling-3.1-flash ein Modell mit 560 Milliarden Parametern veröffentlicht, und das zu einem Zeitpunkt, an dem chinesische KI-Labore im Wochenrhythmus neue, hocheffiziente Architekturen vorstellen.
Für Entwickler und IT-Entscheider ist die Zahl 560 Milliarden zunächst beeindruckend, aber wenig aussagekräftig ohne Kontext. Entscheidend ist, dass Ling-3.1-flash pro Anfrage nur rund 25 Milliarden Parameter aktiv nutzt. Dieser Artikel ordnet ein, was das technisch bedeutet, wie das Modell im Wettbewerbsumfeld steht und wo es bereits heute nutzbar ist.
Inhaltsverzeichnis
Key Takeaways
- Ling-3.1-flash ist ein Mixture-of-Experts-Modell von Ant Group / InclusionAI mit 560 Milliarden Gesamtparametern, von denen pro Anfrage nur rund 25 Milliarden aktiviert werden.
- Das Kontextfenster reicht nativ bis zu 1 Million Token, auf manchen Plattformen werden aktuell 256K Token ausgeliefert.
- Das Modell ist auf Coding, mehrstufige Analysen und Agenten-Workflows mit Tool-Nutzung ausgelegt.
- Zugang besteht unter anderem über Vercel AI Gateway (befristet kostenlos bis 13. Oktober 2026) und Novita AI als Serverless-API.
- Ling-3.1-flash folgt auf Ling-3.0-flash (124B Parameter, Juli 2026, MIT-Lizenz) und reiht sich in den Trend günstiger, effizienter chinesischer MoE-Modelle ein.
Was ist Ling-3.1-flash? Technische Daten im Überblick
Ling-3.1-flash wurde am 29. und 30. September 2026 von Ant Group über das Forschungslabor InclusionAI veröffentlicht. Die Modellbezeichner lauten inclusionai/ling-3.1-flash und inclusionai/ling-3.1-flash-free, je nach Plattform und Lizenzmodell. Das Modell gehört zur Ling-Serie, die Ant Group seit 2025 für Entwickler- und Unternehmensanwendungen aufbaut.
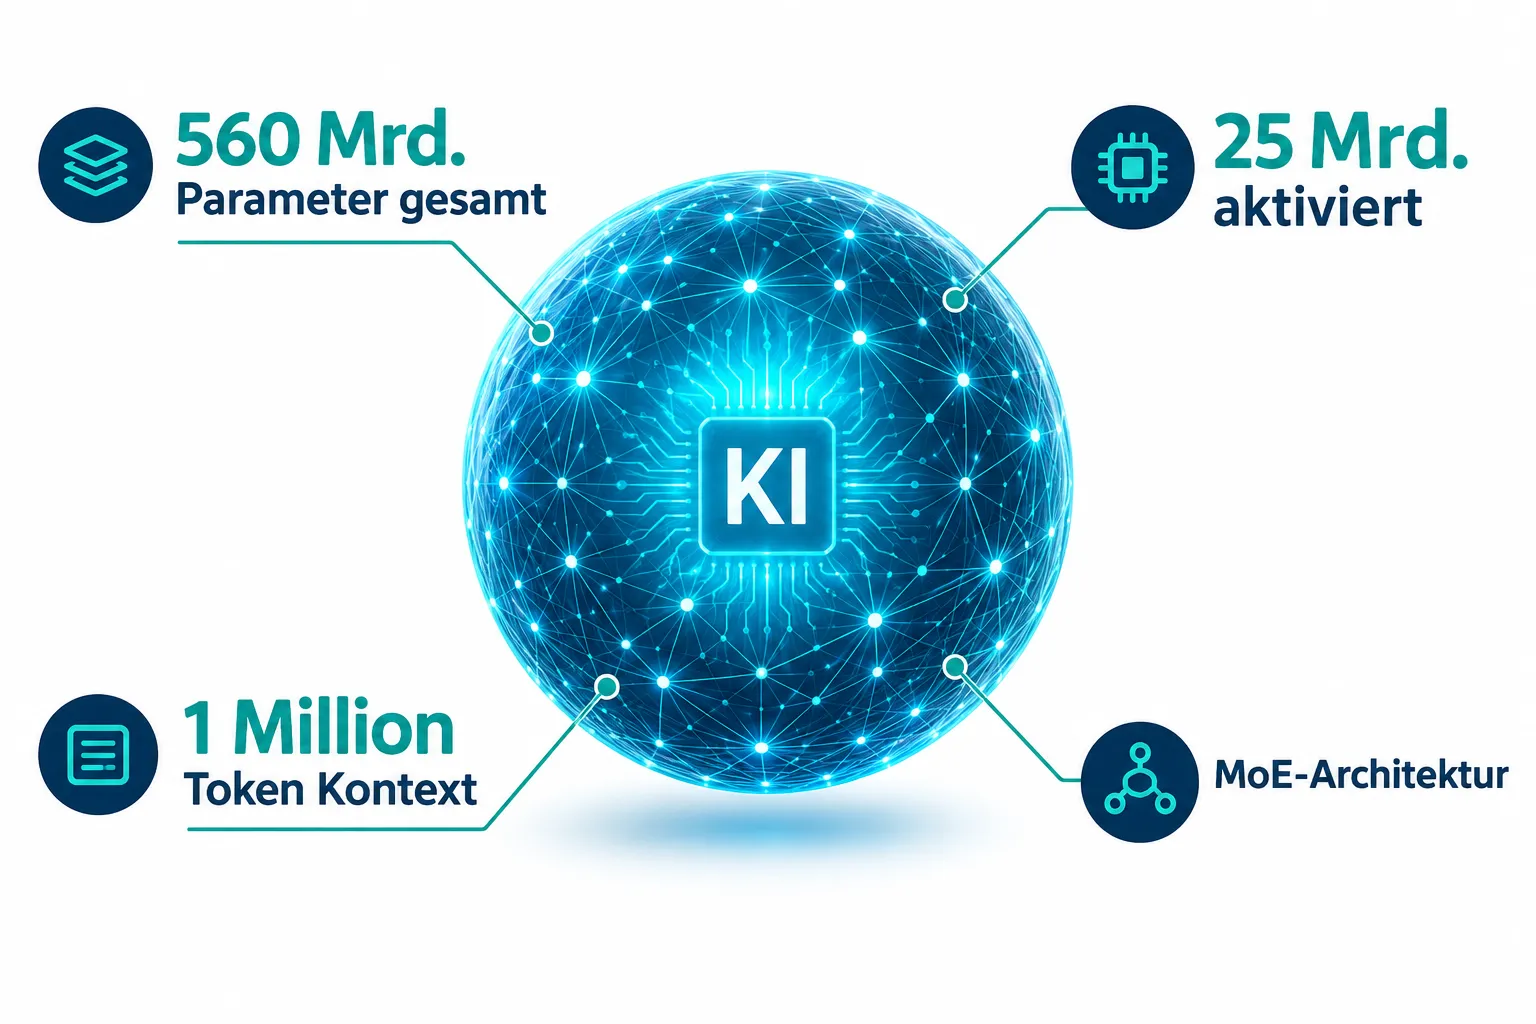
Die zentralen technischen Eckdaten lassen sich wie folgt zusammenfassen:
| Merkmal | Wert |
|---|---|
| Architektur | Mixture-of-Experts (MoE) |
| Gesamtparameter | 560 Milliarden |
| Aktivierte Parameter pro Anfrage | rund 25 Milliarden |
| Kontextfenster (nativ) | bis zu 1 Million Token |
| Kontextfenster (einige Plattformen) | 256.000 Token |
| Veröffentlichung | 29.,30. September 2026 |
| Herausgeber | Ant Group / InclusionAI |
Das große Kontextfenster ist für die Praxis besonders relevant. Ein Modell, das bis zu einer Million Token verarbeiten kann, lässt sich auf vollständige Code-Repositories, lange technische Dokumentationen oder mehrstufige Agentenverläufe anwenden, ohne dass Inhalte ständig gekürzt oder neu zusammengefasst werden müssen. In der Praxis liefern einige Hosting-Anbieter derzeit nur 256K Token aus, ein Hinweis darauf, dass die volle Kontextkapazität schrittweise in die Infrastruktur verschiedener Plattformen eingebunden wird.
Mixture-of-Experts erklärt: Warum 560 Milliarden Parameter effizient sein können
Um zu verstehen, warum Ling-3.1-flash trotz seiner Größe als „flash"-Modell, also als schnelle und kosteneffiziente Variante, positioniert wird, lohnt sich ein kurzer Blick auf die zugrunde liegende Architektur.
Ein klassisches, „dichtes" Sprachmodell nutzt bei jeder Anfrage alle seine Parameter. Ein Modell mit 560 Milliarden Parametern wäre in dieser Bauweise extrem rechenintensiv und langsam. Mixture-of-Experts geht einen anderen Weg: Das Modell besteht aus vielen spezialisierten Teilnetzen, den sogenannten „Experten". Für jede einzelne Anfrage entscheidet ein vorgeschalteter Mechanismus, der Router, welche Experten tatsächlich benötigt werden. Nur diese ausgewählten Experten werden aktiviert und rechnen mit.
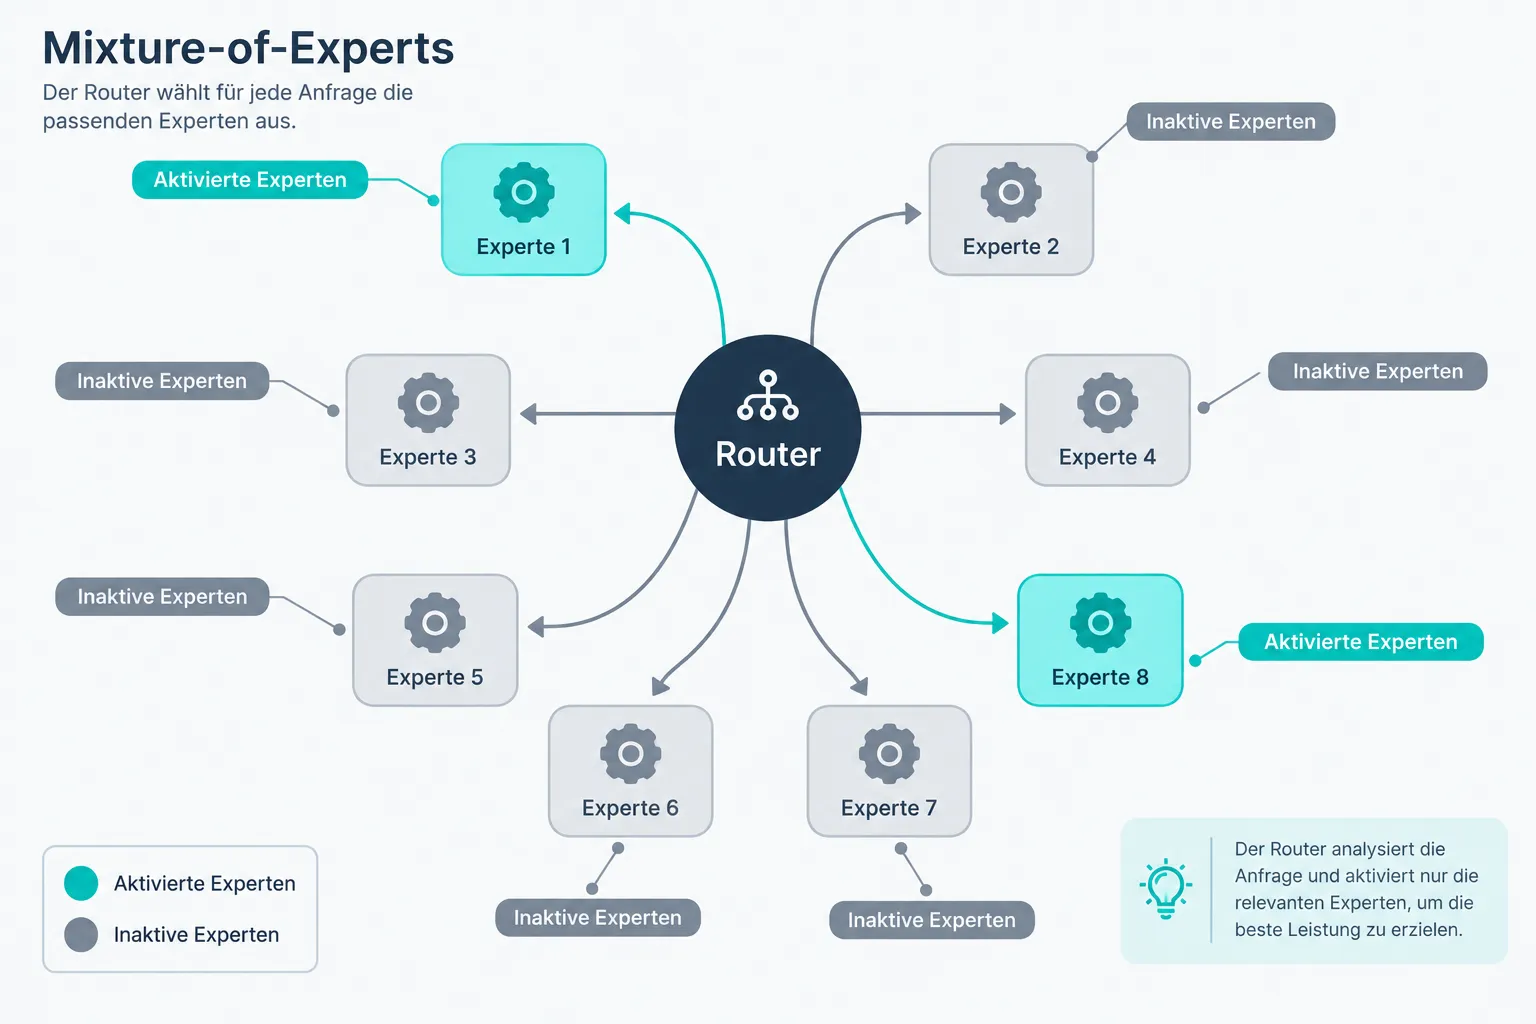
Bei Ling-3.1-flash bedeutet das konkret: Von den 560 Milliarden Gesamtparametern sind für eine typische Anfrage nur etwa 25 Milliarden tatsächlich aktiv, rund 4,5 Prozent des Gesamtmodells. Das hat zwei praktische Folgen:
- Geringere Rechenkosten pro Anfrage, weil nicht das gesamte Netzwerk durchlaufen werden muss.
- Große Wissensbasis trotzdem erhalten, weil das Modell insgesamt auf eine sehr breite Zahl an spezialisierten Teilnetzen zugreifen kann, je nach Aufgabenart.
Diese Kombination aus großer Gesamtkapazität und schlanker Aktivierung ist der Grund, warum MoE-Architekturen seit 2024/2025 zum Standard für große, aber bezahlbare Modelle geworden sind. Ling-3.1-flash reiht sich damit in eine Reihe von Modellen ein, die versuchen, die Qualität sehr großer Netzwerke mit der Geschwindigkeit kleinerer Modelle zu verbinden.
Ling-3.1-flash im Vergleich zum Vorgänger Ling-3.0-flash
Der direkte Vorgänger, Ling-3.0-flash, wurde im Juli 2026 unter MIT-Lizenz als Open-Weight-Modell veröffentlicht. Er verfügte über 124 Milliarden Gesamtparameter, von denen 5,1 Milliarden pro Anfrage aktiviert wurden.
Der Sprung zu Ling-3.1-flash ist in mehreren Dimensionen deutlich:
| Merkmal | Ling-3.0-flash | Ling-3.1-flash |
|---|---|---|
| Veröffentlichung | Juli 2026 | September 2026 |
| Gesamtparameter | 124 Milliarden | 560 Milliarden |
| Aktivierte Parameter | 5,1 Milliarden | rund 25 Milliarden |
| Lizenz | MIT, Open Weight | je nach Plattform / API-Zugang |
| Fokus | Allgemeine Aufgaben | Coding, Agenten-Workflows, lange Dokumente |
Die Vergrößerung sowohl der Gesamtparameter als auch der aktivierten Parameter um einen Faktor von etwa 4,5 bis 5 deutet darauf hin, dass Ant Group bei Ling-3.1-flash stärker auf komplexere, mehrstufige Aufgaben zielt, also genau jene Anwendungsfälle, bei denen ein Modell über mehrere Schritte hinweg konsistent bleiben muss, etwa bei der Analyse großer Codebasen oder bei Agenten, die mehrere Werkzeuge nacheinander aufrufen.
„Ein Modell, das lange Kontexte verarbeiten und dabei mehrere Werkzeuge koordinieren kann, ist für Agenten-Anwendungen oft wichtiger als reine Benchmark-Werte."
Verfügbarkeit: Wo Ling-3.1-flash heute nutzbar ist
Entwickler können Ling-3.1-flash aktuell über mehrere Kanäle testen und integrieren. Zwei Zugangswege stechen hervor:
- Vercel AI Gateway: Das Modell ist hier unter den Bezeichnern inclusionai/ling-3.1-flash und inclusionai/ling-3.1-flash-free verfügbar. Als Einführungsangebot ist die Nutzung bis zum 13. Oktober 2026 kostenlos, danach ist mit regulärer, nutzungsbasierter Abrechnung zu rechnen.
- Novita AI: Hier steht Ling-3.1-flash als Serverless-API bereit, was eine Integration ohne eigene Infrastruktur für Inferenz ermöglicht.
Für IT-Entscheider ist diese Mehrgleisigkeit relevant: Ein Modell, das über mehrere unabhängige Plattformen verfügbar ist, reduziert das Risiko eines Single-Vendor-Lock-ins und erlaubt einen Vergleich von Latenz, Preisstruktur und Verfügbarkeit, bevor eine produktive Entscheidung getroffen wird. Wer Ling-3.1-flash evaluieren möchte, sollte die kostenlose Testphase über Vercel nutzen, um erste Benchmarks mit eigenen Workloads durchzuführen, bevor eine langfristige API-Anbindung über Novita AI oder andere Anbieter aufgebaut wird.
Anwendungsfälle: Coding, Agenten-Workflows und lange Dokumente
Ant Group positioniert Ling-3.1-flash gezielt für drei Einsatzbereiche:
- Coding-Unterstützung: Durch das große Kontextfenster kann das Modell größere Codeabschnitte oder sogar ganze Repository-Ausschnitte gleichzeitig analysieren, was bei Refactoring, Fehlersuche und Dokumentation hilfreich ist.
- Mehrstufige Analysen: Lange Berichte, Vertragswerke oder technische Spezifikationen lassen sich ohne Zerstückelung verarbeiten.
- Agenten-Workflows mit Tool-Nutzung: Das Modell ist darauf ausgelegt, in mehreren Schritten mit externen Werkzeugen, etwa Suchfunktionen, Code-Ausführung oder Datenbankabfragen, zu interagieren und dabei den Überblick über lange Aufgabenverläufe zu behalten.
Für Entwicklerteams, die bereits Agenten-Frameworks einsetzen, ist besonders die Kombination aus großem Kontextfenster und vergleichsweise günstiger Aktivierungslast interessant: Lange Agentenverläufe, die über viele Zwischenschritte Kontext anhäufen, profitieren direkt von der Million-Token-Kapazität.
Einordnung im globalen KI-Wettlauf
Ling-3.1-flash erscheint nicht isoliert. Es ist Teil einer breiteren Bewegung chinesischer KI-Labore, die seit 2025 verstärkt auf MoE-Architekturen setzen, um große Modellkapazität mit niedrigen Betriebskosten zu verbinden. Zu den aktiven Akteuren in diesem Feld zählen: Zur gleichen Zeit sorgte in den USA mit Google Gemini 4 Argon ein völlig anderes KI-Modell für Schlagzeilen, allerdings mit Fokus auf Cybersicherheit statt auf kosteneffiziente Agenten-Workflows.
- Alibaba Qwen, mit mehreren offenen und kommerziellen MoE-Modellreihen.
- DeepSeek, bekannt für aufsehenerregende Effizienzgewinne bei großen Modellen.
- Zhipu AI, mit eigenen Agenten- und Reasoning-fokussierten Modellen.
- Ant Group / InclusionAI, mit der Ling-Serie, zu der Ling-3.1-flash gehört.
Im Vergleich zu den großen US-amerikanischen Anbietern wie OpenAI (GPT-Reihe) und Google (Gemini-Reihe) verfolgen diese chinesischen Labore häufig eine Strategie der schnellen, kostengünstigen Verfügbarkeit über offene Gewichte oder günstige APIs. Das unterscheidet sich vom eher geschlossenen, Enterprise-fokussierten Ansatz vieler westlicher Frontier-Modelle.
Wichtig für die Einordnung: In derselben Woche wie Ling-3.1-flash sorgte auch Google DeepMind mit einem eigenen, völlig unabhängigen Modell für Schlagzeilen, einem auf Cybersicherheit spezialisierten Frontier-Modell. Beide Veröffentlichungen haben keinen inhaltlichen oder technischen Zusammenhang; sie stammen von unterschiedlichen Herstellern, basieren auf unterschiedlichen Architekturen und verfolgen unterschiedliche Zwecke. Dieser Artikel behandelt ausschließlich Ling-3.1-flash von Ant Group und InclusionAI.
Häufig gestellte Fragen zu Ling-3.1-flash
Ist Ling-3.1-flash ein Open-Source-Modell? Der Vorgänger Ling-3.0-flash wurde unter MIT-Lizenz mit offenen Gewichten veröffentlicht. Für Ling-3.1-flash variiert der Zugang je nach Plattform, teils über kostenlose Einführungsangebote, teils über kostenpflichtige APIs.
Welches Kontextfenster bietet Ling-3.1-flash tatsächlich? Nativ unterstützt das Modell bis zu 1 Million Token. Einige Plattformen liefern aktuell nur 256.000 Token aus, abhängig von der jeweiligen Infrastruktur-Integration.
Für welche Aufgaben ist Ling-3.1-flash besonders geeignet? Ant Group nennt explizit Coding-Aufgaben, mehrstufige Dokumentenanalysen und Agenten-Workflows mit Tool-Nutzung als Kernzielgruppen.
Wie unterscheidet sich Ling-3.1-flash von Gemini 4 Argon? Es handelt sich um zwei vollständig unabhängige Modelle unterschiedlicher Hersteller. Ling-3.1-flash stammt von Ant Group/InclusionAI und ist ein MoE-Modell für Coding und Agenten-Aufgaben. Gemini 4 Argon ist ein separates Frontier-Modell von Google DeepMind mit Fokus auf Cybersicherheit.
Fazit und nächste Schritte
Ling-3.1-flash zeigt, wie Mixture-of-Experts-Architekturen es ermöglichen, Modelle mit enormer Gesamtkapazität, 560 Milliarden Parameter, praktisch nutzbar zu machen, indem pro Anfrage nur ein Bruchteil davon, rund 25 Milliarden Parameter, aktiviert wird. Zusammen mit einem Kontextfenster von bis zu einer Million Token positioniert sich das Modell klar für Entwickler, die mit langen Codebasen, umfangreichen Dokumenten oder komplexen Agenten-Workflows arbeiten.
Für Entwicklerteams und IT-Entscheider ergeben sich daraus konkrete nächste Schritte: Zunächst lohnt sich ein Test über das kostenlose Einführungsangebot im Vercel AI Gateway, das noch bis zum 13. Oktober 2026 läuft. Parallel kann die Serverless-API von Novita AI genutzt werden, um Latenz und Kosten unter realistischer Last zu prüfen. Wer bereits mit Ling-3.0-flash gearbeitet hat, sollte die eigenen Benchmarks, insbesondere für lange Kontexte und mehrstufige Agentenaufgaben, direkt mit Ling-3.1-flash vergleichen, da die erweiterte Parameterzahl und das größere Kontextfenster messbare Unterschiede bei komplexen Aufgaben erwarten lassen. Angesichts des dynamischen Wettbewerbsumfelds unter chinesischen KI-Laboren empfiehlt sich außerdem eine regelmäßige Beobachtung weiterer Modellupdates, um die eigene Technologiewahl auf aktuellem Stand zu halten.
Referenzen
- Ant Group / InclusionAI, offizielle Modell-Ankündigung Ling-3.1-flash, September 2026.
- Vercel AI Gateway, Dokumentation und Modellkatalog, Stand September/Oktober 2026.
- Novita AI, Produktankündigung Serverless-API für Ling-3.1-flash, September 2026.
- InclusionAI, Veröffentlichung Ling-3.0-flash unter MIT-Lizenz, Juli 2026.