722 Manuskripte an einem einzigen Tag: Am 6. Oktober 2026 hat OpenAI ein Forschungspaket veroeffentlicht, das in der Mathematik-Community fuer Aufsehen sorgt. Ein internes, bislang nicht oeffentlich verfuegbares OpenAI Mathematik KI-Modell hat Hunderte offener Probleme in Mathematik und theoretischer Informatik geloest oder signifikant vorangebracht – dokumentiert in einem frei zugaenglichen GitHub-Repository. Fuer deutsche Entwickler, Forscher und KI-Interessierte markiert dieser Schritt einen der konkretesten bisherigen Belege dafuer, wie weit generative KI-Systeme in der formalen Wissenschaft inzwischen vorgedrungen sind.
Inhaltsverzeichnis
Key Takeaways
- OpenAI veroeffentlichte am 6. Oktober 2026 insgesamt 722 Manuskripte in 372 Ergebnisfamilien unter Apache-2.0-Lizenz auf github.com/openai/math.
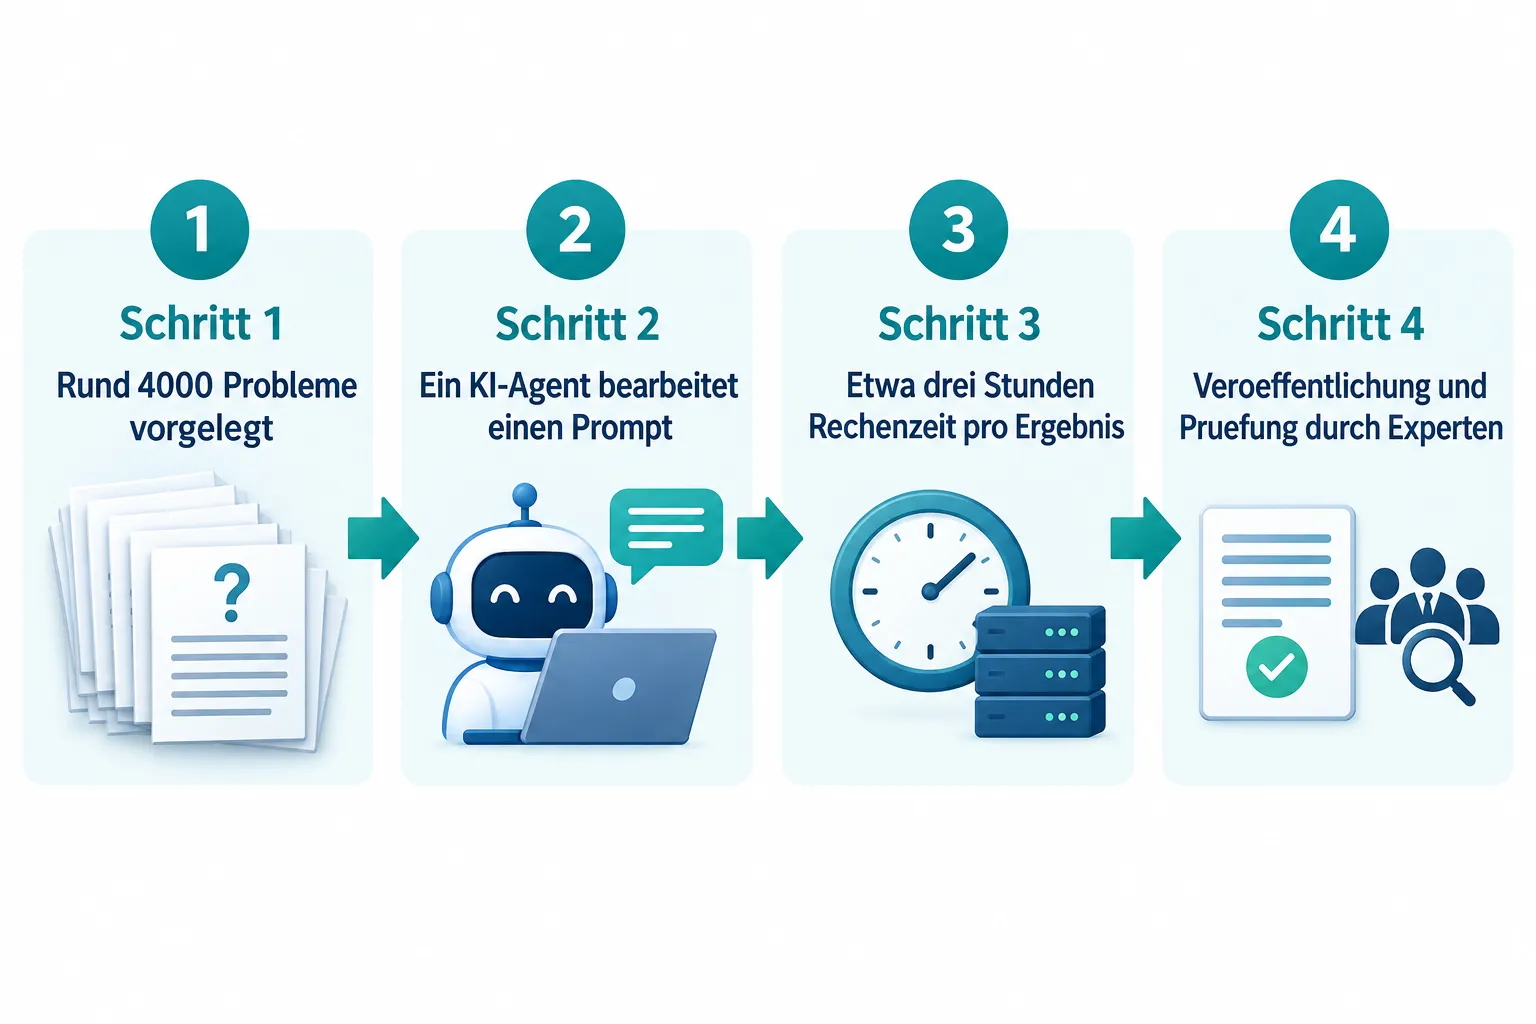
- Ein internes Frontier-Modell bearbeitete rund 4.000 mathematische Probleme; jede Loesung benoetigte im Schnitt etwa drei Stunden ChatGPT-Pro-Denkzeit.
- Fast alle Ergebnisse entstanden durch einen einzigen KI-Agenten auf einen einzigen Prompt – ein deutlicher Unterschied zum vorherigen Navier-Stokes-Vorstoss mit vielen Agenten und hohen Rechenkosten.
- Das Paket enthaelt Lean-Beweisformalisierungen und zehn veroeffentlichte Zusammenfassungen, die den Loesungsweg des Modells nachvollziehbar machen.
- Die Mathematik-Community reagiert gemischt: Anerkennung der Fortschritte trifft auf offene Fragen zu Verifikation und korrekter Zuschreibung.
Was das OpenAI Mathematik KI-Modell veroeffentlicht hat
Im Kern der Veroeffentlichung steht ein Datenpaket von beachtlichem Umfang. OpenAI stellte 722 Manuskripte bereit, die in 372 sogenannte Ergebnisfamilien gegliedert sind. Eine Familie fasst dabei verwandte Arbeiten zusammen: ein Hauptresultat, begleitende Argumente, Folgerungen aus dem Hauptbeweis oder alternative Beweiswege fuer dasselbe Problem. Jede dieser Familien ist einem bestimmten mathematischen Fachgebiet zugeordnet, sodass Forscher gezielt nach ihrem Interessensgebiet suchen koennen.
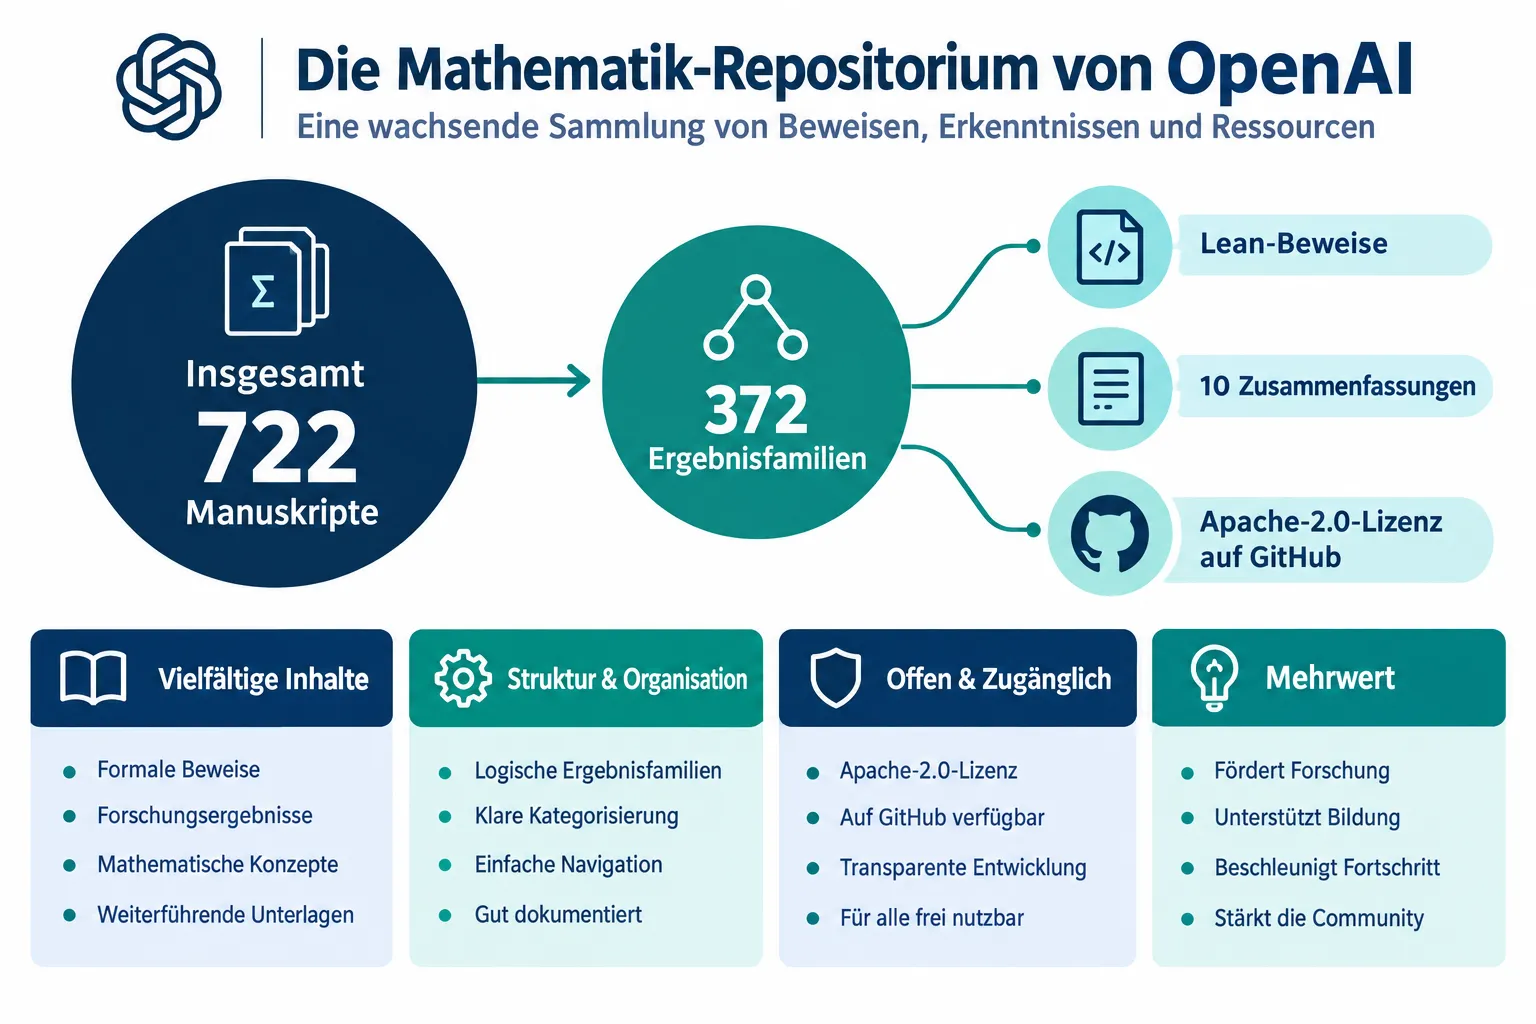
Das gesamte Material liegt oeffentlich im Repository github.com/openai/math und steht unter der Apache-2.0-Lizenz – einer der liberalsten Open-Source-Lizenzen, die sowohl akademische als auch kommerzielle Weiterverwendung erlaubt. Neben den eigentlichen Manuskripten enthaelt das Repository auch Lean-Beweisformalisierungen. Lean ist eine Programmiersprache und ein Beweisassistent, mit dem mathematische Argumente maschinell ueberprueft werden koennen. Diese Formalisierungen sind fuer die Glaubwuerdigkeit der Ergebnisse zentral, weil sie eine zusaetzliche, automatisierte Pruefebene jenseits der menschlichen Begutachtung bieten.
Ergaenzt wird das Paket durch zehn ausgewaehlte Zusammenfassungen. Sie beschreiben in natuerlicher Sprache, wie das Modell bei bestimmten Problemen konkret vorgegangen ist – welche Zwischenschritte es gewaehlt hat, welche Sackgassen es verworfen hat und wie es letztlich zu einer Loesung kam. Fuer Entwickler und Mathematiker, die nachvollziehen wollen, wie ein KI-System tatsaechlich "denkt", sind diese Dokumente die zugaenglichsten Einstiegspunkte in das gesamte Paket.
Wie das OpenAI Mathematik KI-Modell arbeitet: Methode und Rechenaufwand
Hinter den veroeffentlichten Ergebnissen steht ein internes Frontier-Modell von OpenAI, das der Oeffentlichkeit bislang nicht zugaenglich ist. Diesem Modell wurden rund 4.000 mathematische Probleme vorgelegt. Im Durchschnitt benoetigte das System fuer die Loesung eines einzelnen Problems eine Rechenleistung, die etwa drei Stunden ChatGPT-Pro-Denkzeit entspricht. Diese Zahl gibt einen greifbaren Massstab dafuer, wie rechenintensiv selbst fortgeschrittene KI-Modelle bei echter mathematischer Forschung arbeiten – weit jenseits der Sekunden oder Minuten, die man von alltaeglichen Chatbot-Anfragen kennt.
Besonders bemerkenswert ist laut Berichten von Scientific American ein methodischer Unterschied zur vorherigen Arbeit: Fast alle neu veroeffentlichten Ergebnisse wurden von einem einzigen KI-Agenten als Antwort auf einen einzigen Prompt erzeugt. Das steht im deutlichen Kontrast zum fruehren Vorstoss rund um das Navier-Stokes-Problem, bei dem ein grosser Schwarm von KI-Agenten eingesetzt wurde und der Rechenaufwand Berichten zufolge in die Millionen Dollar ging. Die neue, schlankere Vorgehensweise deutet darauf hin, dass die zugrunde liegende Modellarchitektur effizienter geworden ist – ein einzelner Agent kann offenbar heute leisten, wofuer vor wenigen Monaten noch massive parallele Rechenressourcen notwendig waren.
Die Ergebnisse selbst umfassen Loesungen oder signifikante Fortschritte zu Hunderten offener Probleme in Mathematik und theoretischer Informatik. "Offene Probleme" bedeutet in diesem Zusammenhang Fragestellungen, fuer die es zuvor keine vollstaendigen, anerkannten Beweise gab. Dass ein KI-System in dieser Breite greifbare Fortschritte liefert, ist fuer die Forschungsgemeinschaft ein bedeutsames Signal – unabhaengig davon, wie die einzelnen Resultate letztlich im Detail bewertet werden.
Vom Navier-Stokes-Durchbruch zur breiten Veroeffentlichung
Die Oktober-Veroeffentlichung steht nicht isoliert da. Rund einen Monat zuvor, im September 2026, hatte OpenAI bereits angekuendigt, dass ein internes Modell das Navier-Stokes-Existenz-und-Glattheitsproblem geloest habe. Dieses Problem gehoert zu den sieben Millennium-Prize-Problemen des Clay Mathematics Institute – einer Liste besonders schwieriger, jahrzehntealter mathematischer Fragestellungen, fuer deren Loesung historisch hohe Preisgelder ausgesetzt wurden.
Die beiden Ereignisse zusammen zeichnen ein klares Bild der Entwicklung: Zunaechst ein aufwendiger, ressourcenintensiver Einzelerfolg bei einem der bekanntesten offenen Probleme der Mathematik, gefolgt von einer deutlich breiteren, aber methodisch schlankeren Demonstration an Hunderten weiteren Problemen. OpenAI positioniert die aktuelle Veroeffentlichung damit als Beleg dafuer, dass der Navier-Stokes-Erfolg kein isolierter Zufallstreffer war, sondern Teil einer systematischeren Faehigkeit des Modells, in der mathematischen Forschung voranzukommen.
Fuer das Verstaendnis des OpenAI Mathematik KI-Modells ist dieser Vergleich wichtig: Die Entwicklung zeigt eine Verschiebung von Einzelprojekten mit enormem Rechenaufwand hin zu einem wiederholbaren, skalierbaren Ansatz. Genau diese Skalierbarkeit duerfte fuer die weitere Forschung entscheidender sein als jedes einzelne geloeste Problem fuer sich.
Kritische Stimmen: Verifikation und Zuschreibung
So beeindruckend die Zahlen auch wirken, die Reaktionen aus der Mathematik-Community fallen gemischt aus. Auf der einen Seite steht Begeisterung ueber das Tempo und den Umfang der KI-Fortschritte. Auf der anderen Seite werden grundlegende Fragen aufgeworfen, die sich nicht allein mit beeindruckenden Zahlen beantworten lassen.
Zwei Themenkomplexe stehen dabei im Vordergrund:
- Verifikation: Wie laesst sich bei Hunderten neuer Ergebnisse sicherstellen, dass jeder einzelne Beweis tatsaechlich korrekt ist? Die beigefuegten Lean-Formalisierungen helfen, decken aber nicht automatisch jedes veroeffentlichte Resultat vollstaendig ab.
- Zuschreibung (Credit): Mehrere der behandelten Probleme wurden moeglicherweise bereits zuvor von menschlichen Mathematikern bearbeitet oder teilweise geloest. Es stellt sich die Frage, wie fruehere menschliche Vorarbeiten angemessen anerkannt werden, wenn ein KI-System am Ende die vollstaendige Loesung praesentiert.
"Begeisterung ueber die KI-Fortschritte trifft auf offene Fragen zur Verifikation und zur korrekten Zuschreibung von Forschungsergebnissen."
Um diesen Herausforderungen zu begegnen, hat OpenAI eine unabhaengige "Advisory Group on Mathematics and Artificial Intelligence" am Institute for Advanced Study konsultiert. Ziel war es, Best Practices fuer die Veroeffentlichung KI-generierter mathematischer Forschung zu entwickeln. Das Ergebnis dieser Zusammenarbeit findet sich direkt im Repository: Es enthaelt dokumentierte Protokolle fuer Paper-Revisionen und fuer Zitierungen, die nachvollziehbar machen sollen, wie Ergebnisse ueberarbeitet wurden und wie fruehere Arbeiten referenziert werden. Diese Transparenzmassnahme ist ein direkter Versuch, den Kritikpunkten rund um Verifikation und Credit zu begegnen – ob sie ausreicht, wird die Fachwelt in den kommenden Monaten beurteilen.
Eckdaten im Ueberblick
Die folgende Tabelle fasst die zentralen verifizierten Fakten zur Veroeffentlichung zusammen.
| Kennzahl | Wert |
|---|---|
| Veroeffentlichungsdatum | 6. Oktober 2026 |
| Anzahl Manuskripte | 722 |
| Anzahl Ergebnisfamilien | 372 |
| Vorgelegte Probleme | rund 4.000 |
| Rechenzeit pro Ergebnis (im Schnitt) | etwa 3 Stunden ChatGPT-Pro-Denkzeit |
| Veroeffentlichte Zusammenfassungen | 10 |
| Lizenz | Apache-2.0 |
| Repository | github.com/openai/math |
| Vorheriger Meilenstein | Navier-Stokes-Loesung (September 2026) |
Was das fuer deutsche Entwickler und KI-Nutzer bedeutet
Fuer deutsche Entwickler und Tech-Interessierte bietet das Repository einen seltenen, direkten Einblick in die Leistungsfaehigkeit eines Frontier-Modells, das selbst noch nicht oeffentlich zugaenglich ist. Da das gesamte Material unter Apache-2.0-Lizenz steht, koennen Forschungsteams, Universitaeten und auch kommerzielle Anwender die Manuskripte, Beweise und Zusammenfassungen frei einsehen, weiterverarbeiten und zitieren.
Praktisch bedeutet das: Wer sich mit formaler Verifikation, Lean-basierten Beweissystemen oder dem Einsatz von KI in der Forschung beschaeftigt, findet im Repository konkretes Anschauungsmaterial – nicht nur Endergebnisse, sondern auch Einblicke in den Loesungsprozess durch die zehn Zusammenfassungen. Fuer Entwicklerteams, die KI-Agenten fuer komplexe, mehrstufige Denkaufgaben einsetzen wollen, liefert der methodische Ansatz – ein einzelner Agent, ein einzelner Prompt, mehrstuendige Denkzeit – ein reales Beispiel dafuer, wie sich Rechenaufwand und Problemkomplexitaet in der Praxis zueinander verhalten.
Gleichzeitig sollten Nutzer die Einordnung der Fachwelt nicht ignorieren. Die offenen Fragen zur Verifikation bedeuten, dass einzelne Ergebnisse aus dem Paket mit der gebotenen Sorgfalt gepruefte werden sollten, bevor sie als gesichertes Fachwissen weiterverwendet werden.
Ausblick: OpenAIs naechste Schritte in der Mathematik-Forschung
OpenAI hat angekuendigt, weiterhin seine fortschrittlichsten Modelle an Mathematik- und anderen wissenschaftlichen Problemen zu testen. Die Erwartung dahinter: KI-Systeme koennten Forschern in Zukunft neue Werkzeuge fuer Entdeckungen liefern, die weit ueber das hinausgehen, was mit klassischen Methoden allein moeglich war.
Die Kombination aus oeffentlicher Transparenz – durch das offene Repository und die Zusammenarbeit mit der Advisory Group – und fortlaufender interner Modellentwicklung legt nahe, dass weitere Veroeffentlichungen dieser Art folgen werden. Ob sich das aktuelle OpenAI Mathematik KI-Modell oder ein Nachfolger irgendwann der breiten Oeffentlichkeit als Produkt zugaenglich macht, bleibt offen. Klar ist jedoch, dass die Mathematik-Community diesen Prozess weiterhin kritisch begleiten wird – mit Blick auf Verifikation, Zuschreibung und die Frage, welchen tatsaechlichen Mehrwert KI-generierte Beweise fuer die Wissenschaft langfristig bringen.
Fazit
Die Veroeffentlichung von 722 Manuskripten in 372 Ergebnisfamilien ist mehr als eine beeindruckende Zahl – sie ist ein konkreter Datenpunkt dafuer, wie schnell sich die Faehigkeiten von KI-Systemen in der formalen Mathematik weiterentwickeln. Der Uebergang von einem rechenintensiven Schwarm-Ansatz beim Navier-Stokes-Problem zu einem einzelnen Agenten mit einem einzigen Prompt zeigt, dass die zugrunde liegende Technologie effizienter wird, nicht nur leistungsfaehiger.
Fuer deutsche Entwickler und KI-Interessierte lohnt sich ein eigener Blick ins Repository github.com/openai/math: Wer verstehen will, wie ein Frontier-Modell komplexe Beweisfuehrung angeht, findet dort mit den zehn Zusammenfassungen einen seltenen, konkreten Einstieg. Gleichzeitig gilt es, die kritischen Stimmen aus der Mathematik-Community ernst zu nehmen – insbesondere zu Fragen der Verifikation und der korrekten Zuschreibung fruehrer menschlicher Forschungsleistungen. Der naechste sinnvolle Schritt fuer interessierte Leser: die veroeffentlichten Protokolle zu Paper-Revisionen und Zitierungen pruefen und die weitere Entwicklung von OpenAIs Mathematik-Initiative aktiv verfolgen.
Mehr zu aktuellen OpenAI-Transparenzmassnahmen: OpenAI Wasserzeichen fuer ChatGPT in der EU.