Ein einzelner GPT-4-Aufruf mit einem 6.000 Token langen System-Prompt kann pro Antwort mehr kosten als ein fein abgestimmtes, kleineres Modell für dieselbe Aufgabe [2]. Das ist der Kern der Debatte um Fine-Tuning vs Prompt Engineering: Es geht nicht darum, welche Methode grundsätzlich "besser" ist, sondern welche für einen konkreten Anwendungsfall wirtschaftlich und technisch sinnvoll ist. Wer bereits Prompt Engineering und RAG-Systeme kennt, stellt sich früher oder später die Frage, ob sich der nächste Schritt, das Training eines eigenen Modells, lohnt. Dieser Artikel liefert die Entscheidungsgrundlage.
Inhaltsverzeichnis
Key Takeaways
- Prompt Engineering stößt bei Kontextfenster, Konsistenz und Kosten für lange, wiederholte Prompts an klare Grenzen.
- Fine-Tuning verändert die Gewichte eines Basis-Modells dauerhaft, im Gegensatz zu RAG, das externes Wissen zur Laufzeit einspeist.
- Die Baseline-Strategie 2026 lautet: zuerst Prompt Engineering plus RAG testen, erst danach Fine-Tuning in Betracht ziehen [3][6].
- PEFT/LoRA-Verfahren senken die Einstiegshürde für Fine-Tuning erheblich und sind oft der sinnvollere Zwischenschritt vor einem vollständigen Fine-Tune [1][7].
- Fine-Tuning lohnt sich bei großen, stabilen Datenmengen, wiederkehrenden Spezialaufgaben und Compliance-Vorgaben, nicht bei sich schnell änderndem Wissen.
Die Grenzen von Prompt Engineering in der Praxis
Prompt Engineering ist der richtige Einstieg für die meisten KI-Projekte, das haben wir im Grundlagenartikel Prompt Engineering für Einsteiger: So bekommst du bessere KI-Antworten bereits gezeigt. Doch mit wachsender Komplexität zeigen sich vier wiederkehrende Grenzen.
Oft löst bereits eine gut aufgebaute Wissensdatenbank das Problem, mehr dazu in unserem Guide RAG-Systeme bauen: Wie du eigene KI-Wissensdatenbanken erstellst. Grundlegende Techniken zum Formulieren von Prompts findest du in unserem Artikel Prompt Engineering für Einsteiger: So bekommst du bessere KI-Antworten.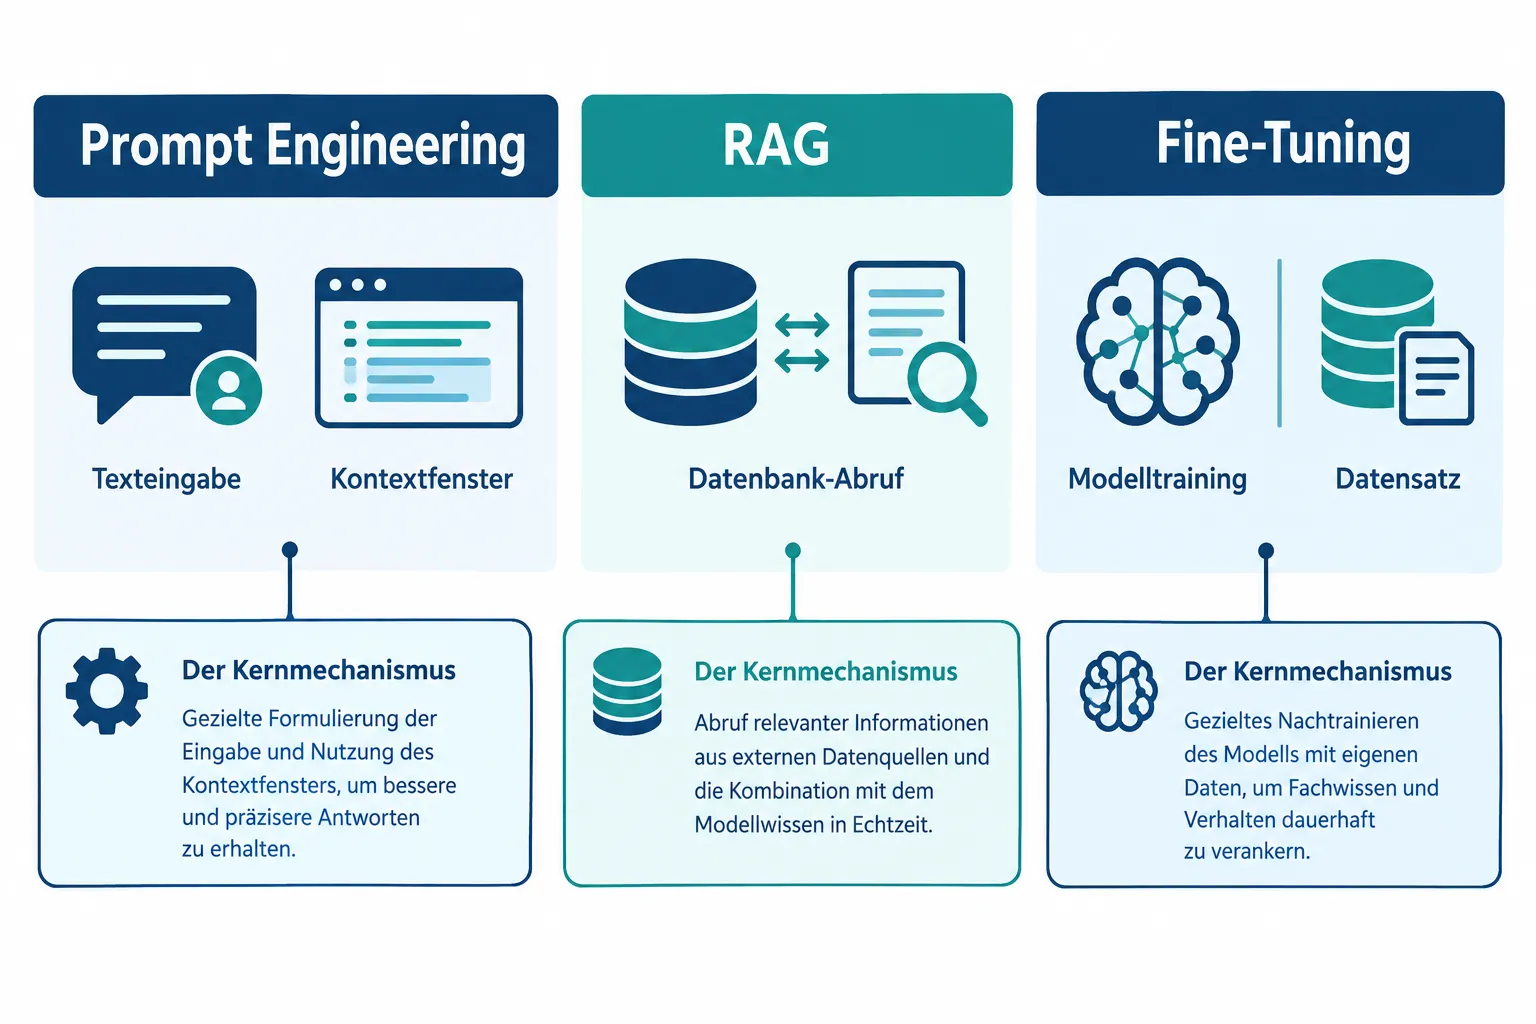
Erstens das Kontextfenster: Auch große Modelle haben ein Limit für Eingabetokens. Wer viel Fachwissen, Beispiele oder Style-Guides in jeden Prompt packen muss, verschenkt Kapazität und Performance.
Zweitens die Konsistenz: Bei komplexen Aufgaben liefert dasselbe Prompt-Template über hunderte Anfragen hinweg oft schwankende Ergebnisse in Ton, Struktur oder Genauigkeit, besonders kritisch bei regulierten Branchen.
Drittens die Kosten pro Anfrage: Lange Prompts mit umfangreichem Few-Shot-Kontext werden bei jedem einzelnen API-Call erneut abgerechnet. Bei hohem Anfragevolumen summiert sich das schnell zu einem relevanten Kostenfaktor [2][5].
Viertens fehlendes Spezialwissen: Ein allgemeines Basis-Modell kennt firmenspezifische Terminologie, interne Prozesse oder Nischen-Fachsprache nicht zuverlässig, egal wie geschickt der Prompt formuliert ist [9].
Was ist Fine-Tuning genau, Fine-Tuning vs Prompt Engineering im technischen Vergleich
Fine-Tuning bedeutet, ein bereits trainiertes Basis-Modell mit eigenen, aufgabenspezifischen Datensätzen weiter zu trainieren. Dabei werden die internen Gewichte des Modells angepasst, das Modell "lernt" dauerhaft neue Muster, statt sie bei jeder Anfrage neu erklärt zu bekommen [3][10].
Der entscheidende Unterschied zu Prompt Engineering: Prompt Engineering verändert nur die Eingabe, nicht das Modell selbst. Das Modell bleibt bei jedem Aufruf identisch, lediglich die Formulierung der Anfrage steuert das Ergebnis.
Auch RAG (Retrieval-Augmented Generation) verändert das Modell nicht. Stattdessen wird zur Laufzeit relevantes Wissen aus einer externen Datenbank abgerufen und dem Prompt hinzugefügt. RAG ist damit ideal für aktuelles, sich häufig änderndes Faktenwissen, während Fine-Tuning eher für stabile Muster, Stil und Struktur geeignet ist [3][6]. Wie man ein solches System konkret aufbaut, ist Thema des separaten Leitfadens RAG-Systeme bauen auf diesem Blog.
Ein wichtiger technischer Hinweis für 2026: Statt eines vollständigen Fine-Tunes, bei dem alle Modellparameter neu trainiert werden, setzen viele Teams heute auf PEFT-Verfahren wie LoRA (Low-Rank Adaptation). Dabei wird nur ein kleiner Bruchteil der Parameter angepasst, das senkt Trainingskosten und Infrastrukturaufwand erheblich, bei oft vergleichbarer Qualität [1][7].
Kosten- und Aufwandsvergleich: Fine-Tuning vs Prompt Engineering im Betrieb
Der wirtschaftliche Vergleich ist selten eindimensional. Er umfasst mehrere Kostenblöcke, die sich zeitlich unterschiedlich verteilen.
Prompt Engineering / RAG:
- Geringe Einstiegskosten, keine Trainingsinfrastruktur nötig
- Laufende API-Kosten steigen mit Prompt-Länge und Anfragevolumen
- Schnelle Iteration, aber wiederkehrende "Kosten pro Token" bei jeder Anfrage [2]
Fine-Tuning:
- Hoher initialer Aufwand für Datenaufbereitung (Sammeln, Bereinigen, Labeln)
- Trainingskosten je nach Modellgröße und Verfahren (bei LoRA/PEFT deutlich niedriger als Full Fine-Tuning) [1][7]
- Zusätzliche Infrastruktur für Hosting des eigenen Modells, wenn kein Managed-Service genutzt wird
- Wartungsaufwand: Re-Training bei neuen Daten oder Modell-Updates
Enterprise-Analysen zeigen, dass sich Fine-Tuning bei hohem, wiederkehrendem Anfragevolumen amortisiert, weil kürzere Prompts pro Anfrage die laufenden Kosten senken, ein feinabgestimmtes Modell braucht oft keinen langen Kontext mehr, um korrekt zu antworten [2][8]. Gleichzeitig berichten Praxisguides von messbaren Genauigkeitsgewinnen bei spezialisierten Aufgaben nach Fine-Tuning, verglichen mit reinem Prompting desselben Basis-Modells [8].
Wann lohnt sich Fine-Tuning wirklich, und wann reichen Prompt Engineering oder RAG?
Die Baseline-Strategie für 2026 lautet in offiziellen Leitfäden großer Anbieter klar: zuerst Prompt Engineering und RAG ausschöpfen, Fine-Tuning erst dann prüfen, wenn diese Methoden an ihre Grenzen stoßen [3][10]. Die Roadmap vieler Unternehmen folgt daher dem Muster Pilot → Prompt/RAG → Fine-Tuning → ggf. eigenes Modell [6].
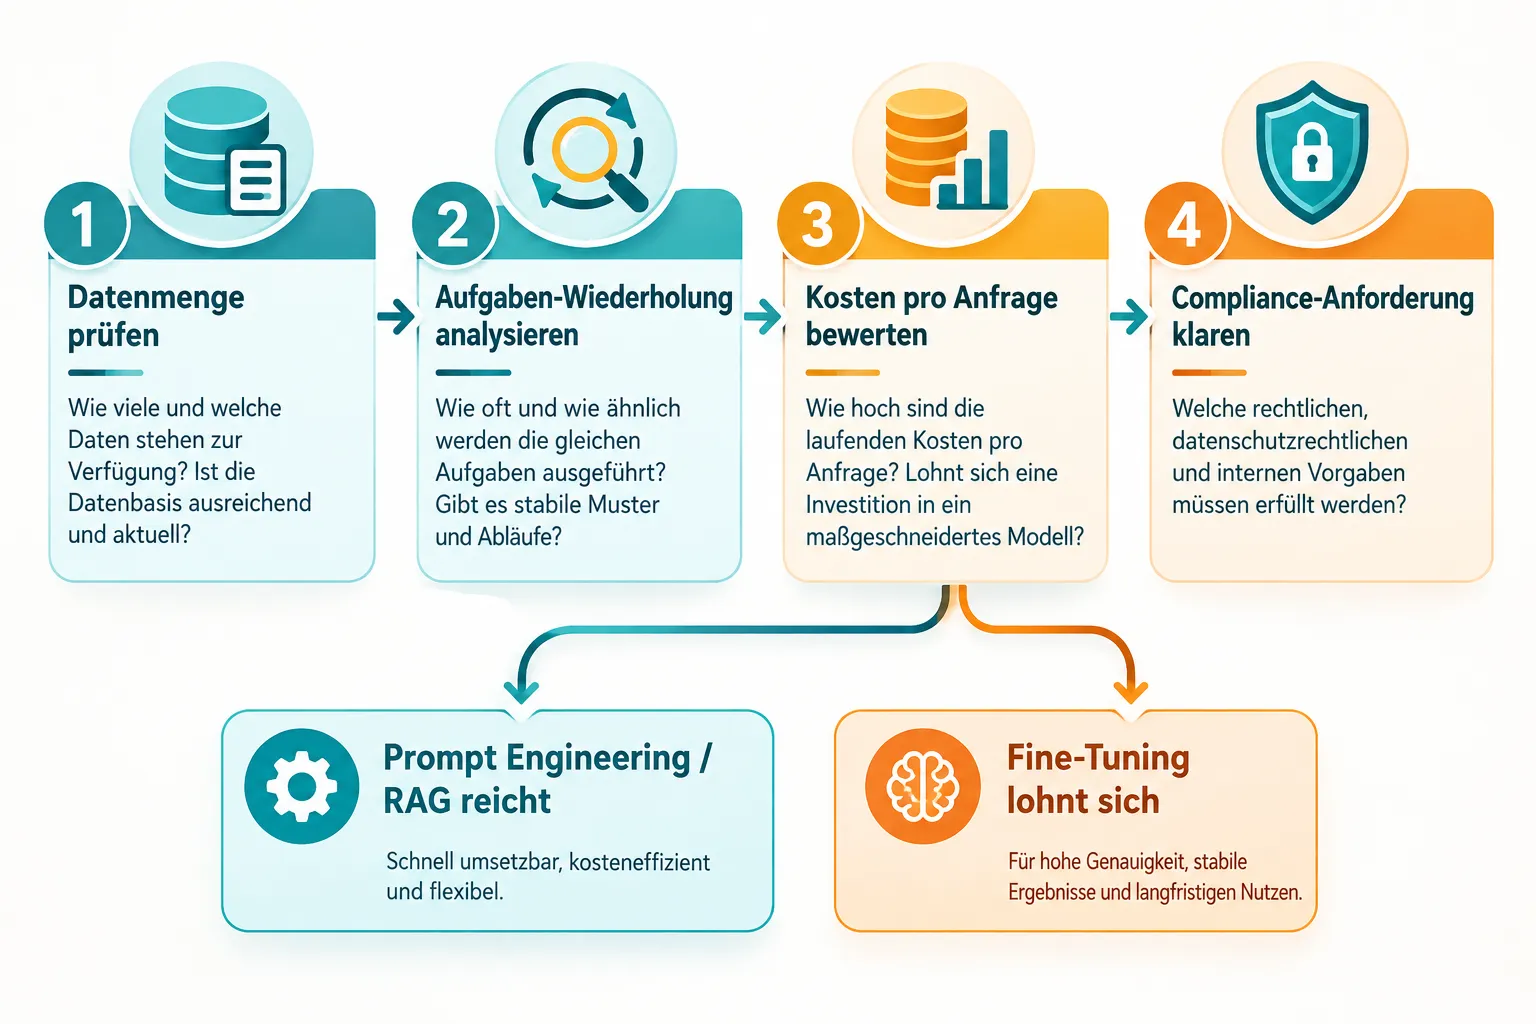
Fine-Tuning lohnt sich, wenn:
- Große, qualitativ hochwertige Trainingsdatenmengen vorhanden sind
- Eine wiederkehrende, klar abgegrenzte Spezialaufgabe automatisiert werden soll (z. B. Klassifikation, Extraktion in einem festen Format)
- Ton, Stil oder Formatierung über tausende Anfragen konsistent bleiben müssen
- Lange, komplexe Prompts durch trainiertes Verhalten "komprimiert" werden können, was laufende Kosten senkt
- Compliance- oder On-Premise-Anforderungen ein eigenes, kontrolliertes Modell verlangen
Prompt Engineering oder RAG reichen aus, wenn:
- Sich das benötigte Wissen häufig ändert (aktuelle Fakten, Preise, Produktdaten, klassischer RAG-Fall) [3]
- Nur wenige Trainingsbeispiele verfügbar sind
- Schnelle Iteration und Experimentieren wichtiger sind als maximale Effizienz
- Das Anfragevolumen (noch) gering ist und sich Trainingsaufwand nicht amortisiert
Entscheidungshilfe: Checkliste Fine-Tuning vs Prompt Engineering
Die folgende Übersicht fasst die wichtigsten Entscheidungskriterien zusammen, orientiert an gängigen Enterprise-Bewertungsrastern [6][9].
| Kriterium | Prompt Engineering / RAG | Fine-Tuning |
|---|---|---|
| Datenverfügbarkeit | Wenig bis moderat, kein Trainingsset nötig | Große, saubere Datensätze erforderlich |
| Wissensart | Aktuell, häufig wechselnd | Stabil, wiederkehrende Muster |
| Anfragevolumen | Gering bis mittel | Hoch, viele wiederkehrende Anfragen |
| Kostenfokus | Pay-per-use, steigt mit Prompt-Länge | Hohe Einmalkosten, geringere Kosten pro Anfrage danach |
| Iterationsgeschwindigkeit | Sehr schnell, sofort testbar | Langsamer, Trainingszyklen nötig |
| Compliance / On-Premise | Eingeschränkt bei externen APIs | Volle Kontrolle über Modell und Daten möglich |
| Einstiegsaufwand | Niedrig | Mittel bis hoch (niedriger mit LoRA/PEFT) |
Eine kurze Checkliste zur Selbsteinschätzung:
- Liegen mindestens einige hundert bis tausend qualitativ hochwertige Beispiele vor? Wenn nein, eher Prompt Engineering/RAG.
- Ist die Aufgabe klar abgegrenzt und wiederkehrend, nicht ständig wechselndes Faktenwissen? Wenn ja, spricht das für Fine-Tuning.
- Übersteigen die laufenden API-Kosten für lange Prompts absehbar die Trainingskosten? Dann lohnt sich Fine-Tuning eher.
- Bestehen regulatorische Anforderungen an Datenhaltung oder Modellkontrolle? Dann ist ein eigenes, feinabgestimmtes oder On-Premise-Modell oft unumgänglich.
- Ist schnelle Anpassungsfähigkeit wichtiger als maximale Effizienz? Dann bleibt Prompt Engineering die bessere Wahl.
Fazit
Fine-Tuning vs Prompt Engineering ist keine Entweder-Oder-Entscheidung, sondern eine Frage der Reihenfolge und des Reifegrads eines Projekts. Für die meisten Use-Cases gilt weiterhin: Prompt Engineering und RAG zuerst ausreizen, weil sie schneller, günstiger und flexibler sind. Fine-Tuning wird erst dann wirtschaftlich sinnvoll, wenn große Datenmengen, hohes Anfragevolumen, Konsistenzanforderungen oder Compliance-Vorgaben die Grenzen des reinen Promptings überschreiten. Als nächsten praktischen Schritt lohnt sich ein Blick auf PEFT/LoRA-Verfahren als risikoärmeren Einstieg ins Fine-Tuning, bevor ein vollständiges Modelltraining in Betracht gezogen wird. Wer parallel aktuelles Faktenwissen einbinden muss, sollte zusätzlich den Artikel zum Aufbau von RAG-Systemen auf diesem Blog konsultieren.
References
[1] Fine Tuning Vs Prompt 2025 – https://randomcommits.com/fine-tuning-vs-prompt-2025/ [2] Fine Tuning Vs Prompt Engineering Which One Actually Saves You Money 1bm4 – https://dev.to/pullflow/fine-tuning-vs-prompt-engineering-which-one-actually-saves-you-money-1bm4 [3] Rag Vs Fine Tuning Vs Prompt Engineering – https://www.ibm.com/think/topics/rag-vs-fine-tuning-vs-prompt-engineering [5] Fine Tuning Vs Prompt Engineering Explained – https://simplico.net/2025/12/03/fine-tuning-vs-prompt-engineering-explained/ [6] Rag Vs Fine Tuning Vs Prompt Engineering Enterprise 2026 – https://internative.net/insights/blog/rag-vs-fine-tuning-vs-prompt-engineering-enterprise-2026 [7] Prompt Engineering Vs Fine Tuning Gen Ai – https://smartdev.com/prompt-engineering-vs-fine-tuning-gen-ai/ [8] ijsat – https://www.ijsat.org/papers/2025/2/3098.pdf [9] Fine Tuning Vs Prompt Engineering – https://unicoconnect.com/blogs/fine-tuning-vs-prompt-engineering [10] Fine Tuning – https://developers.openai.com/learn/fine-tuning
Häufige Fragen
Was ist der Unterschied zwischen Fine-Tuning und Prompt Engineering?
Prompt Engineering formuliert Anfragen an ein bestehendes Modell optimal, während Fine-Tuning das Modell selbst mit eigenen Daten weitertrainiert, um sein Verhalten dauerhaft anzupassen.
Wann lohnt sich Fine-Tuning gegenüber Prompt Engineering?
Fine-Tuning lohnt sich vor allem bei hohem Volumen wiederkehrender Aufgaben mit stabilem Format, bei denen ein kleineres, spezialisiertes Modell langfristig günstiger ist als lange Prompts.
Ist Fine-Tuning teurer als Prompt Engineering?
Die Einrichtung von Fine-Tuning ist aufwendiger und teurer, kann sich aber bei hohem Anfragevolumen amortisieren, weil einzelne Antworten dann günstiger und schneller sind.
Kann RAG eine Alternative zu Fine-Tuning sein?
Ja, in vielen Fällen löst bereits eine gut aufgebaute Wissensdatenbank per RAG das Problem fehlender aktueller Informationen, ohne dass ein eigenes Modell trainiert werden muss.