Ein einziger API-Call kann heute eine ganze Kette von manuellen Klicks ersetzen: Ticket erstellen, Status setzen, Team benachrichtigen, Kalender aktualisieren. Genau darin liegt der eigentliche Wert der Notion API, nicht im hübschen Interface, sondern in der Möglichkeit, Notion als programmierbare Datenschicht für eigene Tools zu nutzen.
Dies ist der vierte und letzte Teil der Serie "Notion für Teams". Die vorherigen Artikel behandelten die Grundlagen von Notion für Teams, den Aufbau von Datenbanken und Views sowie die Gestaltung von Team-Workflows und Vorlagen. In diesem Abschlussartikel wechselt die Perspektive: weg von der Oberfläche, hin zum Code. Es geht darum, wie Entwickler die Notion API nutzen, um eigene Automatisierungen, Synchronisationen und Integrationen zu bauen.
Inhaltsverzeichnis
Key Takeaways
- Die Notion API ist eine REST-API mit JSON-Antworten, die über Internal Integrations und Bearer-Token-Authentifizierung angesprochen wird.
- Typische Einsatzfälle sind das automatische Anlegen und Aktualisieren von Datenbank-Einträgen sowie die Synchronisation externer Datenquellen mit Notion.
- Rate-Limits erfordern Retry-Logik mit exponentiellem Backoff und, bei größeren Datenmengen, Batch-Verarbeitung statt Einzelaufrufe.
- Offizielle SDKs (JavaScript, Python) reduzieren Boilerplate-Code, während rohe REST-Calls maximale Kontrolle bei minimalen Abhängigkeiten bieten.
- Die Notion Developer Platform entwickelt sich 2026 spürbar in Richtung Agenten, Workers und Database Sync, ein Trend, den Entwickler bei neuen Projekten mitdenken sollten.
Was ist die Notion API? Grundlagen für Entwickler
Die Notion API ist eine klassische REST-API, die HTTPS-Requests entgegennimmt und JSON zurückliefert. Sie erlaubt lesenden und schreibenden Zugriff auf Seiten, Datenbanken, Blöcke, Kommentare und, mit den jüngsten Erweiterungen, auch auf KI-Notizen und administrative Funktionen über eine erweiterte Admin API [1].
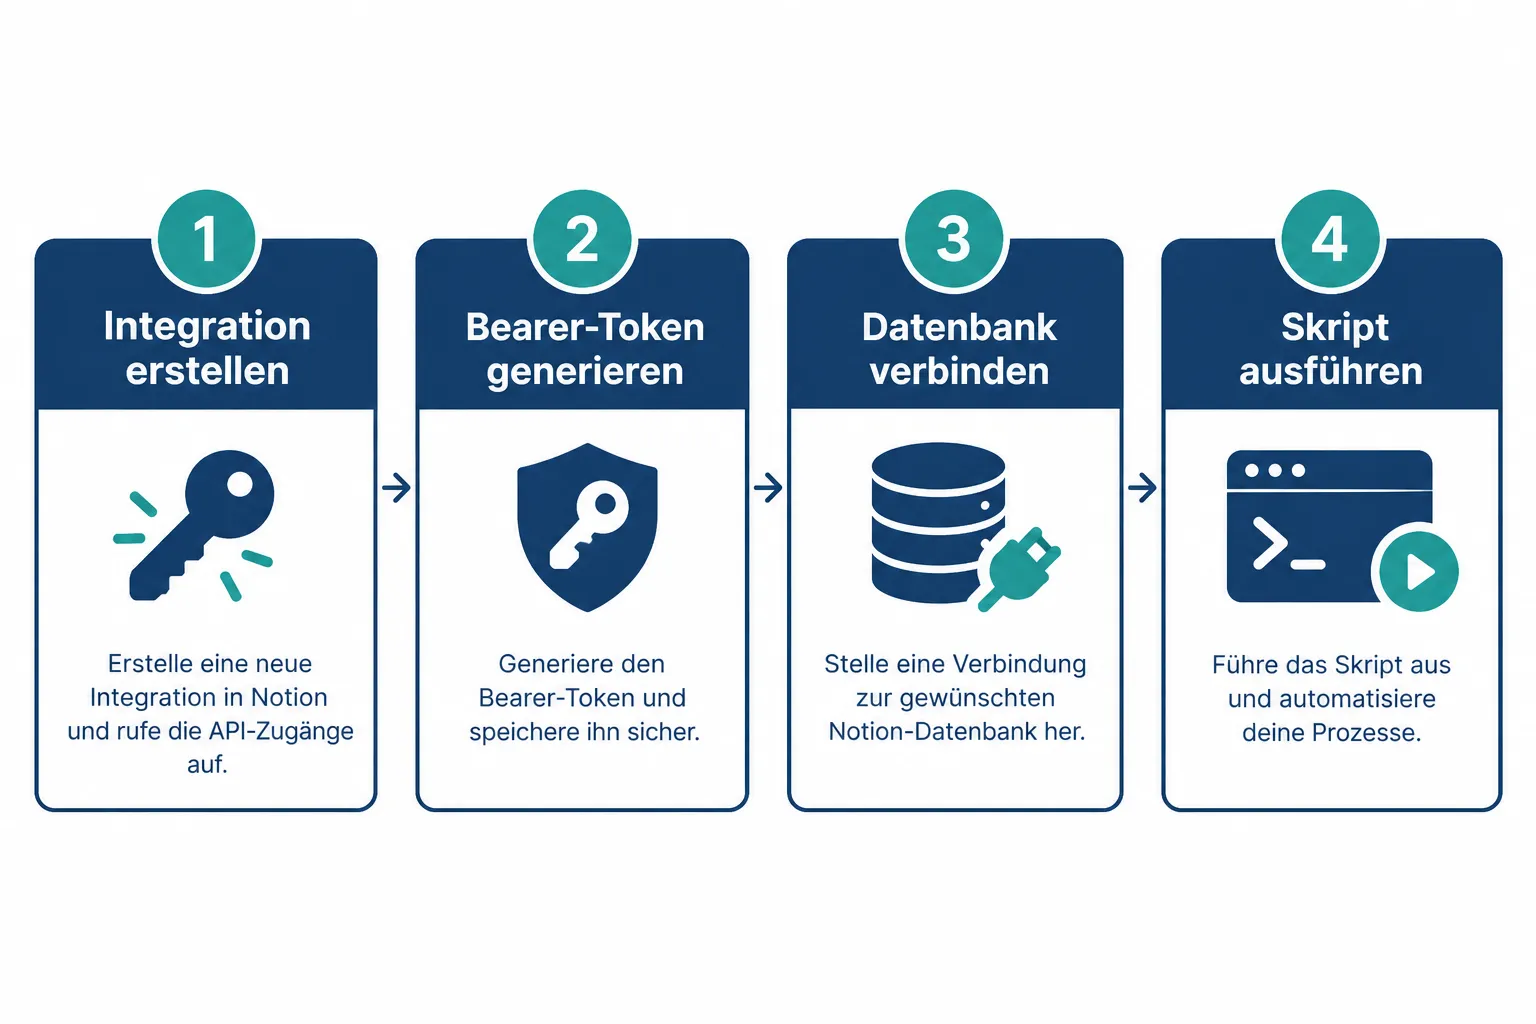
Der Zugriff läuft über sogenannte Integrationen. Für interne Automatisierungen genügt eine Internal Integration: Sie wird im Workspace erstellt, erhält ein Geheimnis (Token) und wird anschließend gezielt mit einzelnen Seiten oder Datenbanken verbunden. Ohne diese explizite Verbindung sieht die Integration, und damit das Skript, gar nichts, selbst mit gültigem Token nicht.
Die Authentifizierung erfolgt per Bearer Token im HTTP-Header:
Authorization: Bearer secret_XXXXXXXXXXXXXXXXXXXXXXXX
Notion-Version: 2022-06-28
Content-Type: application/json
Der Header Notion-Version ist kein Detail, sondern Pflicht. Notion versioniert die API explizit, damit Breaking Changes nicht ungefragt bestehende Integrationen zerstören. Wer den Header vergisst, riskiert unvorhersehbares Verhalten bei künftigen Updates.
Für öffentliche Integrationen, die in mehreren Workspaces laufen sollen, kommt zusätzlich OAuth ins Spiel: Nutzer autorisieren die Integration über einen Consent-Screen, die Integration erhält scope-basierte Capabilities (Lesen, Schreiben, Kommentieren) statt vollem Zugriff. Diese granulare Rechtevergabe ist inzwischen fester Bestandteil des Entwickler-Workflows und wird über das neue Developer Portal verwaltet, das im August 2026 überarbeitet wurde und Integrationen direkt in der Workspace-Oberfläche verwaltbar macht [3].
Typische Anwendungsfälle der Notion API in der Praxis
In der Praxis lassen sich die meisten Notion-API-Projekte auf wenige Muster zurückführen:
- Einträge automatisch anlegen: Formulareingaben, Support-Tickets oder Bestellungen landen als neue Zeile in einer Notion-Datenbank.
- Bestehende Einträge aktualisieren: Status-Felder, Fälligkeitsdaten oder Zuweisungen werden per Skript basierend auf externen Ereignissen geändert.
- Content-Synchronisation: Inhalte aus einem CMS, einem CRM oder einer Excel-Tabelle werden regelmäßig mit Notion abgeglichen, damit Teams nicht zwischen Tools wechseln müssen.
- Reporting und Aggregation: Daten aus mehreren Datenbanken werden ausgelesen, verdichtet und in Dashboards oder Slack-Nachrichten weiterverarbeitet.
Besonders die Synchronisation externer Quellen gewinnt an Bedeutung. Notion selbst treibt dieses Muster mit der Database Sync-Funktion voran, die als strukturelle Grundlage für eigene Automatisierungen dient und Entwicklern erlaubt, externe Datensätze konsistent mit Notion-Datenbanken zu spiegeln [2][8].
Code-Beispiel: Neuen Datenbank-Eintrag per Notion API anlegen
Das folgende Beispiel zeigt, wie ein neuer Eintrag in einer Notion-Datenbank, etwa einem Task-Tracker, per Node.js und fetch angelegt wird. Voraussetzung: Die Integration wurde im Workspace erstellt und mit der Zieldatenbank verbunden.
const NOTION_TOKEN = process.env.NOTION_TOKEN;
const DATABASE_ID = process.env.NOTION_DATABASE_ID;

async function createTask(title, status, dueDate) {
  const response = await fetch("https://api.notion.com/v1/pages", {
    method: "POST",
    headers: {
      Authorization: `Bearer ${NOTION_TOKEN}`,
      "Notion-Version": "2022-06-28",
      "Content-Type": "application/json",
    },
    body: JSON.stringify({
      parent: { database_id: DATABASE_ID },
      properties: {
        Name: {
          title: [{ text: { content: title } }],
        },
        Status: {
          select: { name: status },
        },
        "Due Date": {
          date: { start: dueDate },
        },
      },
    }),
  });

  if (!response.ok) {
    const error = await response.json();
    throw new Error(`Notion API Fehler: ${error.message}`);
  }

  return response.json();
}

createTask("API-Dokumentation aktualisieren", "In Progress", "2026-03-15")
  .then((page) => console.log("Erstellt:", page.id))
  .catch((err) => console.error(err));
Wichtig ist die Struktur der properties: Sie muss exakt den Spaltennamen und -typen der Zieldatenbank entsprechen. Ein select-Feld erwartet ein anderes Objekt als ein date– oder title-Feld. Wer die Property-Typen der Datenbank nicht kennt, kann sie vorab per GET /v1/databases/{database_id} abfragen, das erspart viele Trial-and-Error-Schleifen.
Rate-Limits und Best Practices für stabile Notion-API-Integrationen
Die Notion API begrenzt die Anfragerate pro Integration. Wer diese Grenze überschreitet, erhält einen 429 Too Many Requests-Status samt Retry-After-Header. Für produktive Automatisierungen sind folgende Praktiken empfehlenswert:
- Exponentielles Backoff: Bei einem 429-Fehler nicht sofort erneut senden, sondern die Wartezeit nach jedem Fehlschlag verdoppeln.
- Retry-Logik mit Obergrenze: Nach drei bis fünf Versuchen abbrechen und den Fehler loggen, statt endlos zu wiederholen.
- Batch-Verarbeitung: Bei größeren Datenmengen nicht hunderte Einzelrequests parallel senden, sondern in Chargen mit kurzen Pausen zwischen den Blöcken arbeiten.
- Idempotenz beachten: Vor dem Anlegen eines Eintrags prüfen, ob er bereits existiert (z. B. über eine eindeutige ID-Property), um Duplikate bei Wiederholungsversuchen zu vermeiden.
- Pagination korrekt behandeln: Abfragen über
POST /v1/databases/{id}/queryliefern maximal 100 Ergebnisse pro Seite; dernext_cursormuss iterativ verarbeitet werden.
Ein einfaches Retry-Muster in JavaScript:
async function withRetry(fn, maxAttempts = 5) {
  let attempt = 0;
  while (attempt  setTimeout(r, wait));
    }
  }
  throw new Error("Maximale Anzahl an Versuchen erreicht");
}
Für rechenintensive, dauerhaft laufende Automatisierungen bietet Notion seit August 2026 zudem eine eigene Workers-Runtime mit kreditbasierter Abrechnung an, die es erlaubt, Automatisierungslogik direkt innerhalb der Notion-Plattform auszuführen, statt einen externen Server zu betreiben [3][4]. Das reduziert Infrastrukturaufwand, ist aber vor allem für Teams relevant, die bereits tief in der Notion-Plattform verankert sind.
Notion SDK vs. rohe REST-Calls: Was passt zu deinem Projekt?
Für den Zugriff auf die Notion API stehen zwei grundsätzliche Wege offen: das offizielle SDK oder direkte HTTP-Aufrufe.
| Kriterium | Offizielles SDK | Rohe REST-Calls |
|---|---|---|
| Einstiegsaufwand | Niedrig, klare Methoden | Höher, manuelles Header-Management |
| Abhängigkeiten | Zusätzliches Paket nötig | Keine, nur HTTP-Client |
| Flexibilität | An SDK-Version gebunden | Volle Kontrolle über Requests |
| Wartung | Wird von Notion aktuell gehalten | Eigene Anpassung bei API-Änderungen nötig |
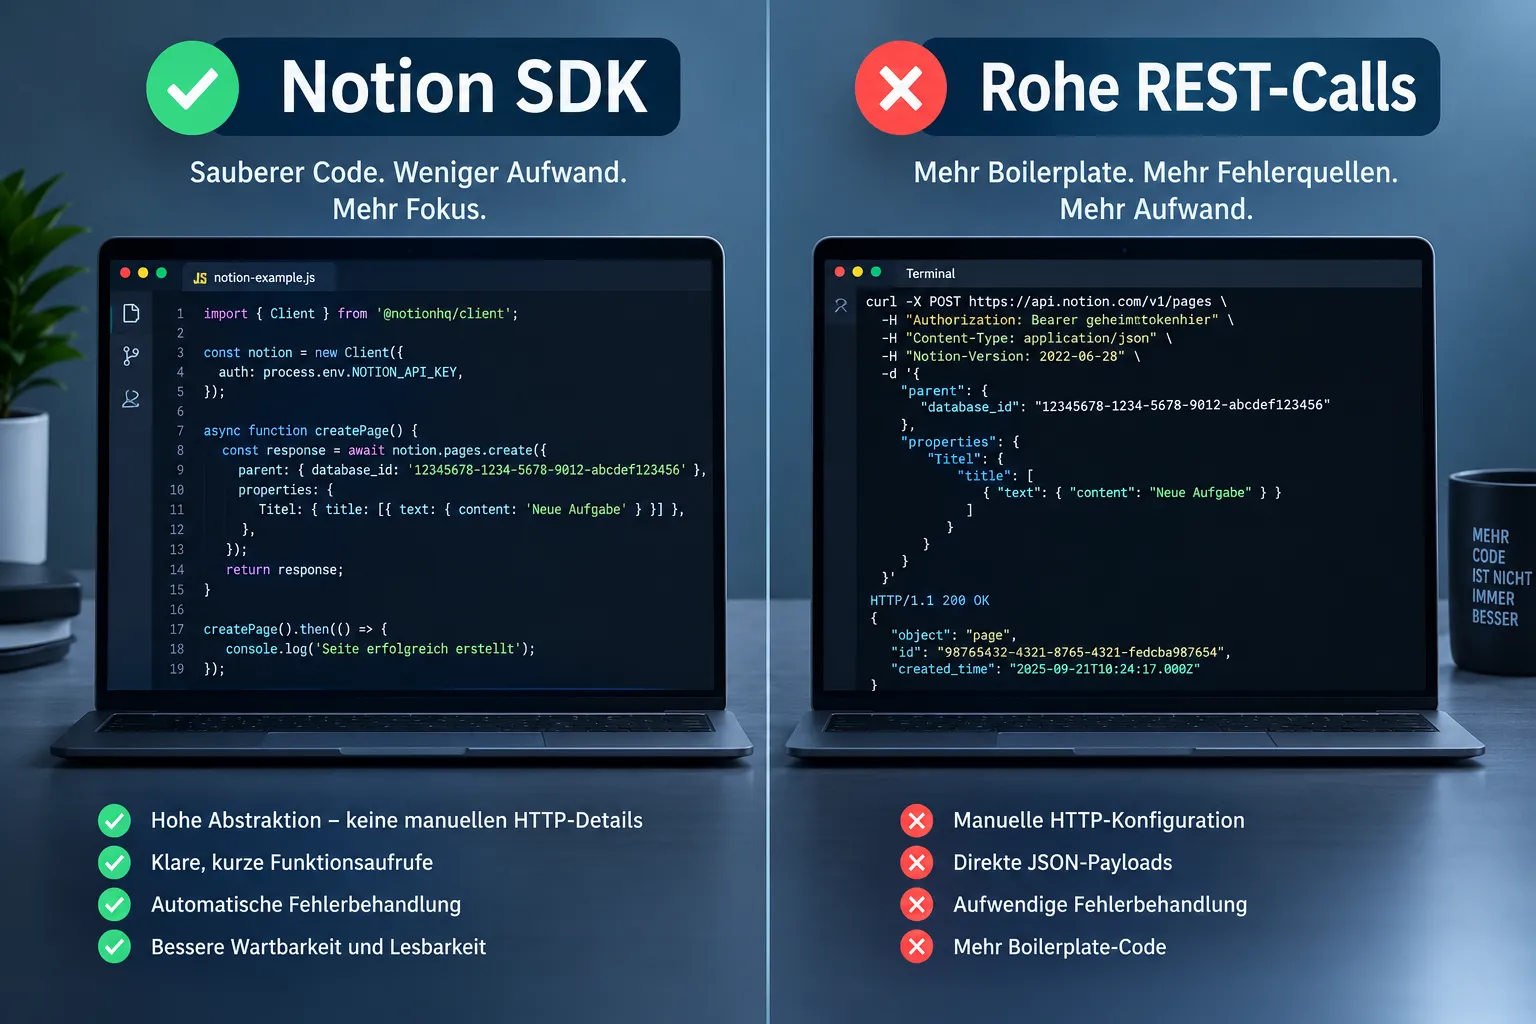
Das offizielle JavaScript- beziehungsweise Python-SDK kapselt Authentifizierung, Header und Pagination in lesbaren Methodenaufrufen. Ein SDK-basierter Aufruf sieht so aus:
from notion_client import Client

notion = Client(auth=NOTION_TOKEN)

notion.pages.create(
    parent={"database_id": DATABASE_ID},
    properties={
        "Name": {"title": [{"text": {"content": "Neue Aufgabe"}}]},
        "Status": {"select": {"name": "Not started"}},
    },
)
Der Code ist kürzer, aber die zugrunde liegende Logik bleibt identisch zum rohen REST-Call. Für kleine Skripte, Prototypen oder Serverless-Functions mit engem Dependency-Budget sprechen rohe Calls für sich; für größere Codebasen mit vielen API-Interaktionen zahlt sich das SDK durch bessere Lesbarkeit und geringere Fehleranfälligkeit aus. Branchenanalysen zu Build-vs-Buy-Entscheidungen bei Automatisierungen kommen regelmäßig zu dem Schluss, dass SDKs die Entwicklungszeit senken, während rohe Integrationen dann sinnvoll sind, wenn maximale Kontrolle über Retry-Verhalten und Payload-Struktur gefragt ist [5][6].
Ausblick: Notion Developer Platform 2026, Workers, Agents und Database Sync
Die Notion Developer Platform hat sich 2026 deutlich in Richtung KI-gesteuerter Automatisierung weiterentwickelt. Neben den bereits erwähnten Workers wurden External Agents und Custom Agents APIs eingeführt, die im dritten Quartal 2026 in die öffentliche Beta übergegangen sind und es erlauben, externe KI-Agenten wie Claude Code, Cursor oder Codex direkt mit Notion-Workspaces zu verbinden [7][9].
Für Entwickler heißt das praktisch: Automatisierungen laufen zunehmend nicht mehr nur als klassische Cron-Skripte, sondern als agentenbasierte Workflows, die über eine Verzeichnisstruktur von Connections und Integrationen orchestriert werden. Die im September 2026 aktualisierte Connections-Übersicht listet mittlerweile eine breite Palette an vorgefertigten Integrationen, die als Ausgangspunkt für eigene Erweiterungen dienen können [10].
Parallel dazu wurden Effizienzverbesserungen für Datenbankoperationen über das Model Context Protocol (MCP) eingeführt, die den Token-Verbrauch bei KI-gestützten Abfragen reduzieren, relevant für alle, die Notion-Daten in LLM-basierte Anwendungen einspeisen [2][8]. Diese Entwicklung ist Teil eines größeren Trends hin zu einem "Agent Hub", in dem Notion nicht nur Datenspeicher, sondern aktiver Orchestrator für KI-gesteuerte Aufgaben ist [9]. Wie stark sich dieser Trend bis Ende 2026 und darüber hinaus festigt, bleibt zwar Spekulation, doch Entwickler, die heute Automatisierungen bauen, sollten Agenten- und Sync-Schnittstellen bei der Architekturentscheidung bereits mitdenken.
Fazit und nächste Schritte
Die Notion API verwandelt Notion von einem reinen Team-Werkzeug in eine programmierbare Plattform. Wer die Grundlagen, Internal Integrations, Bearer-Token-Authentifizierung und die korrekte Struktur von Properties, einmal verstanden hat, kann in wenigen Zeilen Code eigene Automatisierungen bauen: von einfachen Task-Erstellungen bis zu komplexen Synchronisationsprozessen mit externen Systemen.
Für den Einstieg empfiehlt sich ein pragmatischer Weg: zunächst eine Internal Integration anlegen, mit einer Testdatenbank verbinden und das gezeigte Code-Beispiel anpassen. Anschließend lohnt sich der Blick auf Rate-Limit-Handling und Retry-Logik, bevor produktive Workloads darauf aufbauen. Wer regelmäßig größere Datenmengen verarbeitet oder KI-Agenten anbinden möchte, sollte die neueren Funktionen der Notion Developer Platform, Workers, Database Sync und die Agents-APIs, frühzeitig evaluieren, statt sie nachträglich in eine bestehende Architektur zu pressen.
Damit schließt die Serie "Notion für Teams": von den Grundlagen über Datenbanken und Team-Workflows bis hin zur programmatischen Erweiterung per API. Der nächste logische Schritt liegt nun bei jedem Entwickler-Team selbst, im eigenen Workspace, mit eigenem Code.
References
[1] Changelog – https://developers.notion.com/page/changelog [2] Notion Developer Platform 2026 Workers External Agents Api Database Sync Guide 3mea – https://dev.to/akaranjkar08/notion-developer-platform-2026-workers-external-agents-api-database-sync-guide-3mea [3] 2026 08 19 – https://www.notion.com/releases/2026-08-19 [4] 2026 05 13 – https://www.notion.com/releases/2026-05-13 [5] Notion – https://modsignal.io/vendors/notion [6] Notion Releases – https://releases.sh/notion/notion-releases [7] News – https://creatorstoolbox.com/tools/notion/news [8] Notion Developer Platform Workers External Agent Api 2026 – https://effloow.com/articles/notion-developer-platform-workers-external-agent-api-2026 [9] Notion Opens Workspace Claude Code Cursor Codex Native Ai Agents – https://www.techtimes.com/articles/317092/20260525/notion-opens-workspace-claude-code-cursor-codex-native-ai-agents.htm [10] Connections – https://www.notion.com/connections
Häufige Fragen
Wie authentifiziert man sich bei der Notion API?
Über eine Internal Integration mit Bearer-Token im HTTP-Header, kombiniert mit dem Pflicht-Header Notion-Version, der die API-Version festlegt.
Was sind typische Anwendungsfälle für die Notion API?
Automatisches Anlegen und Aktualisieren von Datenbank-Einträgen, Content-Synchronisation mit externen Tools sowie Reporting und Aggregation von Daten aus mehreren Datenbanken.
Wie geht man mit Rate-Limits der Notion API um?
Mit exponentiellem Backoff bei 429-Fehlern, einer Retry-Logik mit Obergrenze, Batch-Verarbeitung bei großen Datenmengen und korrekter Verarbeitung der Pagination über next_cursor.
Offizielles SDK oder rohe REST-Calls für die Notion API?
Das SDK eignet sich für größere Codebasen dank geringerer Fehleranfälligkeit, rohe REST-Calls für kleine Skripte oder Projekte mit engem Dependency-Budget, wenn maximale Kontrolle gefragt ist.