Vierzig Prozent. So viel der Enterprise-Software soll laut Branchenprognosen bis 2026 aufgabenspezifische Agenten enthalten, nicht als Feature-Gimmick, sondern als zentrale Infrastruktur [1][9]. Wer heute noch glaubt, ein Chatbot und ein KI-Agent seien im Grunde dasselbe mit anderem Namen, verpasst den eigentlichen Paradigmenwechsel. KI-Agenten Automatisierung beschreibt genau diesen Sprung: von reaktiven Text-Antworten zu Systemen, die selbstständig planen, Werkzeuge bedienen und mehrstufige Aufgaben bis zum Abschluss durchziehen. Dieser Guide richtet sich an Leser, die Chatbots wie ChatGPT oder Claude bereits produktiv einsetzen und jetzt verstehen wollen, wie autonome Workflows technisch funktionieren, wo ihre Grenzen liegen und mit welchen Frameworks sie 2026 tatsächlich gebaut werden.
Falls du noch keine Erfahrung mit ChatGPT & Co. hast, lies zuerst unseren Einsteiger-Guide “KI für Einsteiger” – dieser Artikel setzt Grundkenntnisse in Prompting und LLM-Nutzung voraus.
Inhaltsverzeichnis
Key Takeaways
- Agenten unterscheiden sich fundamental von Chatbots: Sie führen mehrstufige Aufgaben autonom aus, statt nur auf einzelne Prompts zu reagieren.
- Tool-Use / Function-Calling ist das technische Fundament jeder Agenten-Architektur, ohne strukturierte API-Aufrufe bleibt ein Agent ein reiner Textgenerator.
- Reasoning-Muster wie ReAct und Reflexion entscheiden darüber, ob ein Agent aus Fehlern lernt oder sie fortpflanzt.
- LangGraph, Claude Code und Browser-Agenten sind 2026 die praxisrelevantesten Plattformen für produktive KI-Agenten Automatisierung.
- Kostenkontrolle, Halluzinationsrisiko und Sicherheits-Guardrails sind keine Nebensächlichkeiten, sondern die zentralen Erfolgsfaktoren beim produktiven Einsatz.
Was unterscheidet einen Agenten von einem Chatbot
Ein Chatbot beantwortet eine Frage und wartet auf die nächste Eingabe. Ein KI-Agent bekommt ein Ziel, zerlegt es in Teilschritte, ruft dabei eigenständig Werkzeuge auf, prüft die Ergebnisse und arbeitet weiter, ohne dass nach jedem Schritt ein Mensch eingreifen muss. Genau diese Fähigkeit zur autonomen Mehrschritt-Ausführung macht den Unterschied aus.
Die damit verbundenen Sicherheitsrisiken autonomer Agenten diskutieren wir ausführlich in KI-Sicherheitsdebatte: OpenAI-Breach, Amodei-Warnung und die Risiken autonomer KI-Agenten. Viele Agenten greifen dabei auf eine externe Wissensdatenbank zu, wie wir sie in unserem Artikel RAG-Systeme bauen: Wie du eigene KI-Wissensdatenbanken erstellst beschreiben.Technisch betrachtet ist ein Agent eine Schleife: Das Sprachmodell beobachtet den aktuellen Zustand, entscheidet über die nächste Aktion, führt sie über eine Werkzeugschnittstelle aus, nimmt das Ergebnis wieder auf und wiederholt den Zyklus, bis ein Stoppkriterium erreicht ist [6]. Dominante Architekturmuster dafür sind heute:
- Single-Agent-Tool-Loop, ein Modell, mehrere Werkzeuge, einfache Aufgaben
- Planner, Executor-Split, ein Modell plant, ein anderes führt aus
- Supervisor, Worker-Hierarchie, ein Koordinator verteilt Teilaufgaben an spezialisierte Subagenten
- Graph-/State-Machine-Flows, explizite Zustandsübergänge statt freier Schleifen [6][13]
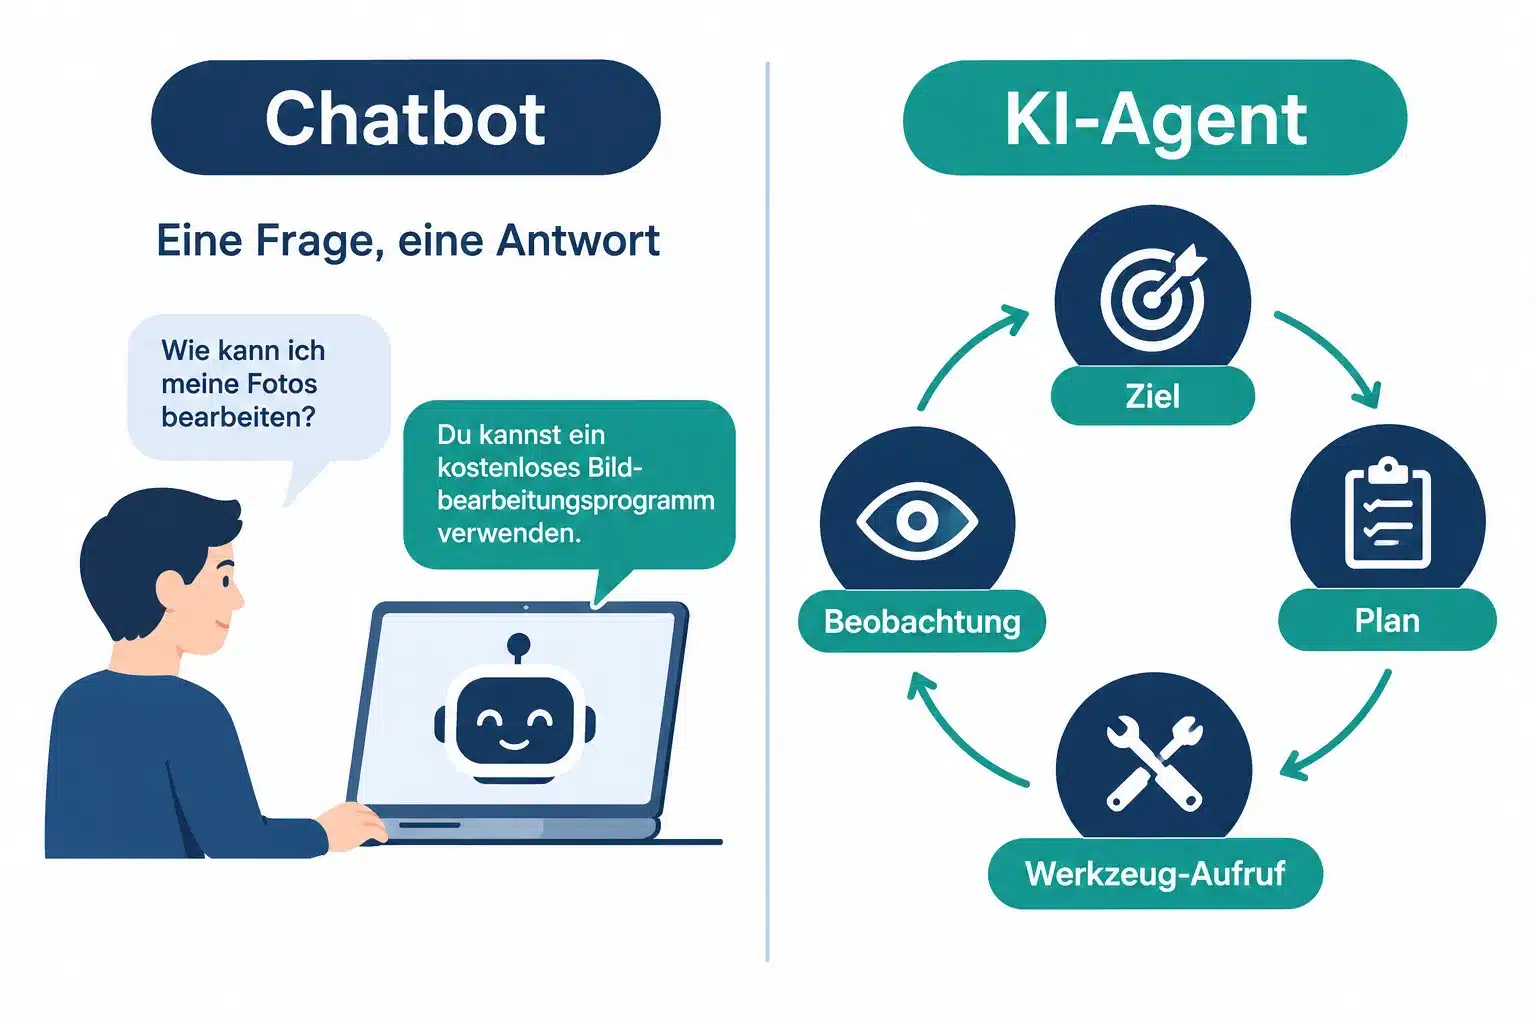
Ein Chatbot antwortet. Ein Agent handelt, und zwar so lange, bis das Ziel erreicht oder ein Abbruchkriterium erfüllt ist.
Diese Unterscheidung ist keine Marketing-Nuance. Sie bestimmt, welche Risiken ein System mitbringt: Ein Chatbot kann höchstens eine falsche Antwort liefern, ein Agent kann eine falsche Kette von Aktionen ausführen, inklusive echter API-Aufrufe, Dateiänderungen oder Zahlungsvorgänge.
Tool-Use und Function-Calling als technisches Fundament der KI-Agenten Automatisierung
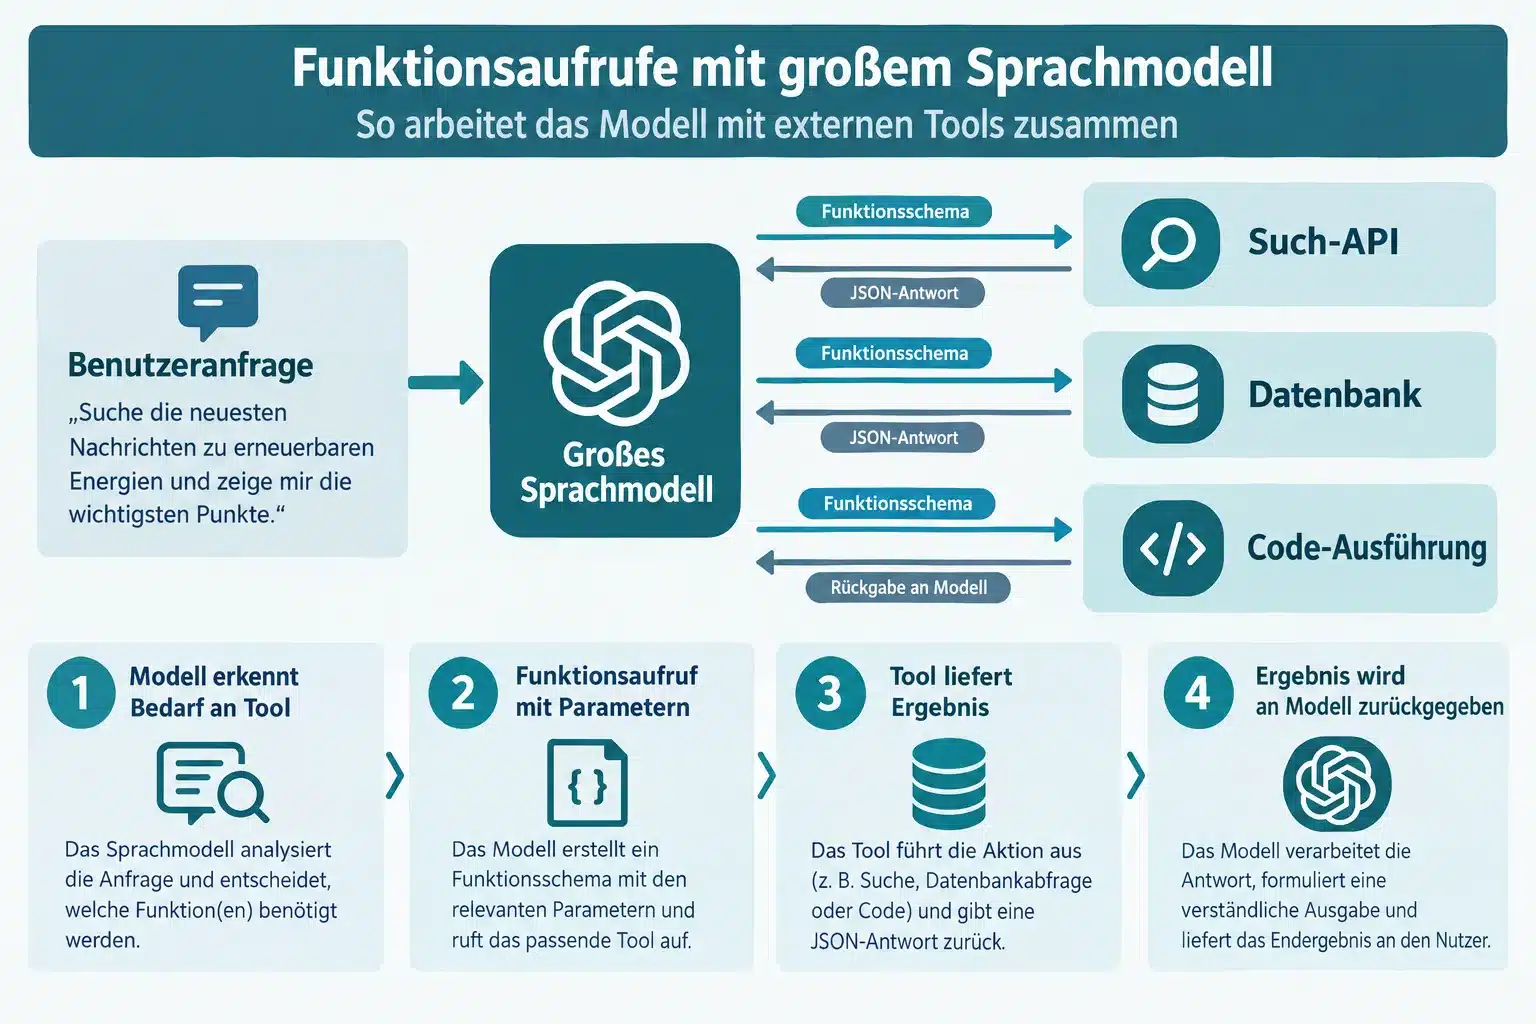
Ohne Tool-Use gibt es keine echte Agenten-Automatisierung. Function-Calling bedeutet, dass das Sprachmodell nicht nur Text erzeugt, sondern strukturierte Aufrufe an definierte Funktionen oder APIs formuliert, etwa eine Websuche, eine Datenbankabfrage oder eine Code-Ausführung. Das Modell entscheidet dabei selbst, welches Werkzeug es wann und mit welchen Parametern aufruft.
Der technische Ablauf sieht typischerweise so aus:
- Das Modell erhält eine Liste verfügbarer Werkzeuge mit Namen, Beschreibung und Parameterschema.
- Basierend auf der aktuellen Aufgabe wählt es ein Werkzeug und generiert die passenden Argumente als strukturiertes Format (meist JSON).
- Das umgebende System führt den eigentlichen Aufruf aus, das Modell selbst hat keinen direkten Zugriff auf externe Systeme.
- Das Ergebnis wird zurück in den Kontext des Modells gespeist, das darauf basierend die nächste Entscheidung trifft.
Praxisleitfäden zu Agenten-Frameworks betonen dabei mehrere technische Schutzmechanismen, die in produktiven Systemen Standard sein sollten: eine harte Begrenzung der Iterationen, meist fünf bis zehn Schritte pro Lauf , eine strikte Validierung jeder Tool-Ausgabe vor der Rückgabe an das Modell sowie Streaming-Ausführung, um Zwischenschritte live nachvollziehen zu können [8]. Ab mehr als zwei aktiven Werkzeugen gilt lückenlose Observability nicht mehr als optional, sondern als Pflicht [8].
Planungs- und Reasoning-Fähigkeiten: Chain-of-Thought, ReAct und Reflexion
Tool-Zugriff allein macht noch keinen intelligenten Agenten. Entscheidend ist, wie das Modell zwischen Beobachtung und Aktion denkt. Drei Reasoning-Muster prägen die heutige KI-Agenten Automatisierung:
Chain-of-Thought (CoT) lässt das Modell seinen Gedankengang in Zwischenschritten ausformulieren, bevor es eine finale Antwort oder Aktion liefert. Das reduziert Sprungschlüsse und macht Fehler nachvollziehbar.
ReAct-Pattern (Reasoning + Acting) verschränkt Denken und Handeln explizit: Das Modell formuliert einen Gedanken, führt eine Aktion aus, beobachtet das Ergebnis, denkt erneut nach, und wiederholt diesen Zyklus. Dieses Muster ist die Grundlage fast aller modernen Tool-Use-Agenten.
Reflexion geht einen Schritt weiter: Nach einem Fehlversuch bewertet der Agent selbst, warum ein Schritt gescheitert ist, und passt seine Strategie für den nächsten Versuch an, eine Form von Selbstkorrektur ohne menschliches Eingreifen.
In produktiven Workflows werden diese Muster über konkrete Metriken überwacht: Task-Erfolgsrate, Korrektheit der Tool-Aufrufe, Halluzinationsrate auf Zwischenschritten, Plan-Treue, Trace-Länge und die sogenannte "unrecoverable error rate", also der Anteil an Läufen, die sich nicht mehr selbst korrigieren [6][8]. Observability-Werkzeuge wie LangSmith oder OpenTelemetry-basierte Trace-Frameworks machen diese Metriken sichtbar, ergänzt durch LLM-Judging, Simulationen und stichprobenartige menschliche Reviews [6][8].
Gängige Frameworks und Plattformen für KI-Agenten Automatisierung
Die Frameworklandschaft hat sich 2026 deutlich konsolidiert. Ein Überblick über die relevantesten Ansätze:
| Framework/Plattform | Kernidee | Typischer Einsatz |
|---|---|---|
| LangGraph | Graph-/State-Machine-basierte Agentensteuerung mit Branching und Retries | Produktive Multi-Agent-Systeme |
| LangChain (Basis) | Werkzeugauswahl und Entscheidungsschleifen | Prototyping, einfache Tool-Use-Agenten |
| Deep Agents | Vorkonfigurierte "Batteries-included"-Agentenumgebung | Schneller Einstieg ohne Eigenbau |
| Claude Code | Coding-Agent mit paralleler Subagenten-Orchestrierung | Codebase-Audits, Migrationen, Refactoring |
| Browser-/Operator-artige Agenten | Steuerung von Webanwendungen über GUI-Interaktion | Recherche, Formularausfüllung, Web-Automatisierung |
LangChain selbst positioniert Agenten explizit als Entscheidungs- und Aktionsschleifen, die Werkzeuge auswählen, aufrufen und basierend auf Zwischenergebnissen weiterplanen. Seit Version 0.3 empfiehlt das Projekt für produktive Agentenlasten primär LangGraph, das im Vergleich zur klassischen Agent-Executor-Logik bessere Debugbarkeit, Branching und Multi-Agent-Koordination bietet [4][7][10].
Für Coding-Aufgaben hat sich Claude Code als eigenständige Kategorie etabliert: Statt einzelner Prompt-Antworten generiert das System dynamische Skripte, die mehrere Subagenten parallel orchestrieren, etwa für großflächige Codebase-Audits oder Recherchen. Ein wiederkehrendes Praxismuster ist der "plan-then-build"-Zyklus, bei dem ein Plan zunächst zur menschlichen Freigabe vorgelegt wird, bevor die eigentliche Ausführung beginnt.
Browser-Agenten nach dem Operator-Prinzip steuern Webanwendungen direkt über die Benutzeroberfläche, nützlich, wenn keine API existiert. Automationsplattformen stufen solche Agenten Anfang 2026 für klar strukturierte Aufgaben wie Extraktion, Klassifikation oder Zusammenfassung als produktionsreif ein, während vollständig autonome, mehrstufige Entscheidungsfindung weiterhin als experimentell gilt [5]. Parallel etabliert sich das Model Context Protocol (MCP) als aufkommender Standard, um Agenten und Werkzeuge einheitlich zu verbinden [5].
Praktische Einsatzbeispiele für autonome AI-Workflows
Drei Bereiche zeigen den praktischen Nutzen von KI-Agenten Automatisierung besonders klar:
Recherche-Automatisierung: Ein Agent zerlegt eine offene Fragestellung in Teilrecherchen, ruft mehrere Suchquellen parallel auf, fasst Zwischenergebnisse zusammen und liefert am Ende einen strukturierten Bericht, statt einer einzelnen, oberflächlichen Antwort.
Coding-Agenten: Statt einzelner Codevorschläge übernehmen Agenten komplette Refactoring-Läufe, Tests und Migrationsprojekte. Claude Code etwa kann mehrere Subagenten gleichzeitig auf verschiedene Teile einer Codebasis ansetzen und die Ergebnisse anschließend zusammenführen.
Content-Pipelines: Von der Themenrecherche über Entwurf bis zur Qualitätsprüfung laufen mehrere Agentenschritte hintereinander, wobei jeder Schritt die Ausgabe des vorherigen als Eingabe nutzt, oft mit einem Reflexions-Schritt, der die eigene Ausgabe vor der Freigabe noch einmal kritisch prüft.
Für kleinere Unternehmen zeigt sich der praktische Nutzen besonders deutlich in vorgefertigten Workflow-Bibliotheken, die zeitgesteuerte Agentenläufe über bestehende Tool-Stacks wie Shopify, Salesforce oder Zapier ermöglichen, ohne dass eigene Infrastruktur neu aufgebaut werden muss.
Grenzen und Risiken der KI-Agenten Automatisierung
Autonome Workflows bringen spezifische Risiken mit sich, die bei einfachen Chatbot-Antworten kaum eine Rolle spielen:
- Halluzination bei mehrstufigen Aufgaben: Ein einzelner falscher Zwischenschritt kann sich über mehrere Iterationen fortpflanzen, bevor er auffällt, die sogenannte Fehlerfortpflanzung.
- Kostenkontrolle bei API-Aufrufen: Jeder Werkzeugaufruf verursacht Kosten. Ohne Iterationsgrenzen und Budget-Caps können Agentenläufe unkontrolliert teuer werden.
- Sicherheitsaspekte bei Tool-Zugriff: Ein Agent mit Schreibrechten auf Dateien, Datenbanken oder Zahlungssystemen kann bei Fehlplanung realen Schaden anrichten, nicht nur eine falsche Textausgabe produzieren.
- Fehlende Nachvollziehbarkeit: Ohne Trace-Logging lässt sich im Nachhinein oft nicht mehr rekonstruieren, warum ein Agent eine bestimmte Entscheidung getroffen hat.
Regulatorisch wirkt sich das auch auf die Gestaltung solcher Systeme aus: Der EU AI Act bringt seit 2025 spezifische Vorgaben für leistungsfähige KI-Modelle, während Hochrisikoregeln stufenweise bis 2026/2027 in Kraft treten [6][12][15]. In der Praxis setzen Unternehmen deshalb auf Governance-Muster wie klar definierte Policy-Grenzen, vollständige Audit-Trails und menschliche Freigabe an kritischen Entscheidungspunkten, etwa bevor ein Agent eine Zahlung auslöst oder produktiven Code deployt.
Praktische Gegenmaßnahme: Rubrics- und szenariobasierte Evaluation statt reiner Unit-Tests, kombiniert mit strikten Iterationslimits, gilt inzwischen als Mindeststandard für produktive Agenten-Deployments [8].
Fazit: Wie Sie KI-Agenten Automatisierung sinnvoll einordnen
KI-Agenten Automatisierung ist kein Hype-Begriff, sondern eine technisch klar definierte Weiterentwicklung des Chatbot-Paradigmas: weg von reaktiven Einzelantworten, hin zu autonomen Schleifen aus Planung, Werkzeugnutzung und Beobachtung. Wer heute Agenten produktiv einsetzen will, sollte drei Dinge priorisieren: erstens ein Framework wählen, das Observability und Iterationsgrenzen von Anfang an mitbringt, etwa LangGraph für allgemeine Workflows oder Claude Code für Coding-Aufgaben. Zweitens strukturierte Metriken wie Task-Erfolgsrate und Trace-Länge früh etablieren, statt Agentenläufe blind zu vertrauen. Drittens kritische Aktionen, Zahlungen, Deployments, Datenänderungen, immer mit menschlicher Freigabe absichern, bis das System nachweislich zuverlässig arbeitet. Wer diese Grundlagen beherrscht, kann Agenten schrittweise von einfachen Recherche-Aufgaben zu komplexeren Automatisierungen ausbauen, ohne unkontrollierte Kosten- oder Sicherheitsrisiken einzugehen.
References
[1] Agentic Ai Takes Over 11 Shocking 2026 Predictions – https://www.forbes.com/sites/markminevich/2025/12/31/agentic-ai-takes-over-11-shocking-2026-predictions/
[4] Langchain Tutorial 2026 – https://blog.jetbrains.com/pycharm/2026/02/langchain-tutorial-2026/
[5] Ai Agents In Automation 2026 – https://automationatlas.io/guides/ai-agents-in-automation-2026/
[6] Agentic Ai Workflows Game Changer Automation Ethics Future – https://futureagi.com/blog/agentic-ai-workflows-game-changer-automation-ethics-future/
[7] Langchain Agents Complete Guide – https://easyclaw.com/blog/ai-agent-101/langchain-agents-complete-guide/
[8] Langchain Agents Tools Functions Practical Guide 2026 – https://freeacademy.ai/blog/langchain-agents-tools-functions-practical-guide-2026
[9] Ai Business Trends Report 2026 – https://blog.google/innovation-and-ai/infrastructure-and-cloud/google-cloud/ai-business-trends-report-2026/
[10] Deepagents – https://github.com/langchain-ai/deepagents
Häufige Fragen
Was unterscheidet einen KI-Agenten von einem normalen Chatbot?
Ein KI-Agent kann eigenständig Aufgaben planen, Werkzeuge aufrufen und mehrstufige Prozesse ausführen, während ein klassischer Chatbot nur auf einzelne Anfragen antwortet.
Was ist Tool-Use bzw. Function-Calling bei KI-Agenten?
Tool-Use erlaubt es einem KI-Agenten, externe Funktionen oder APIs aufzurufen, etwa um Daten abzufragen oder Aktionen auszuführen, statt nur Text zu generieren.
Welche Risiken bergen autonome KI-Agenten?
Autonome Agenten können Fehler in Kettenreaktionen verstärken, unbeabsichtigte Aktionen ausführen oder für Angriffe missbraucht werden, weshalb Kontrolle und Monitoring wichtig sind.
Was ist ReAct bei KI-Agenten?
ReAct ist ein Prompting-Ansatz, bei dem ein Agent abwechselnd nachdenkt (Reasoning) und handelt (Acting), um komplexe Aufgaben schrittweise zu lösen.