535,4 von 600 möglichen Punkten. Diese Zahl hätte bei der International Olympiad in Informatics 2026 jeden einzelnen menschlichen Teilnehmer übertroffen, inklusive des besten Wettkämpfers der Welt. Nvidia hat mit seiner Nemotron-3-Modellfamilie genau dieses Ergebnis erzielt, und nur wenige Wochen später bestätigten offizielle Gutachter der International Mathematical Olympiad ein zweites Gold-Niveau-Resultat. Das Thema Nemotron 3 IOI IMO ist damit binnen kurzer Zeit zu einem der meistdiskutierten KI-Themen des Jahres 2026 geworden, und es lohnt sich, genau hinzuschauen, was wirklich gemessen wurde.
Der Hersteller selbst warnt jedoch vor Übertreibung: Nicht jedes dieser Ergebnisse ist gleich zu bewerten. Ein Lauf war offiziell verifiziert, der andere ausdrücklich inoffiziell. Dieser Artikel ordnet die Fakten ein, erklärt die zugrunde liegende Methodik und zeigt, warum die eigentliche Nachricht weniger ein einzelner Punktestand ist als ein wiederverwendbares Trainingsrezept.
Inhaltsverzeichnis
Key Takeaways
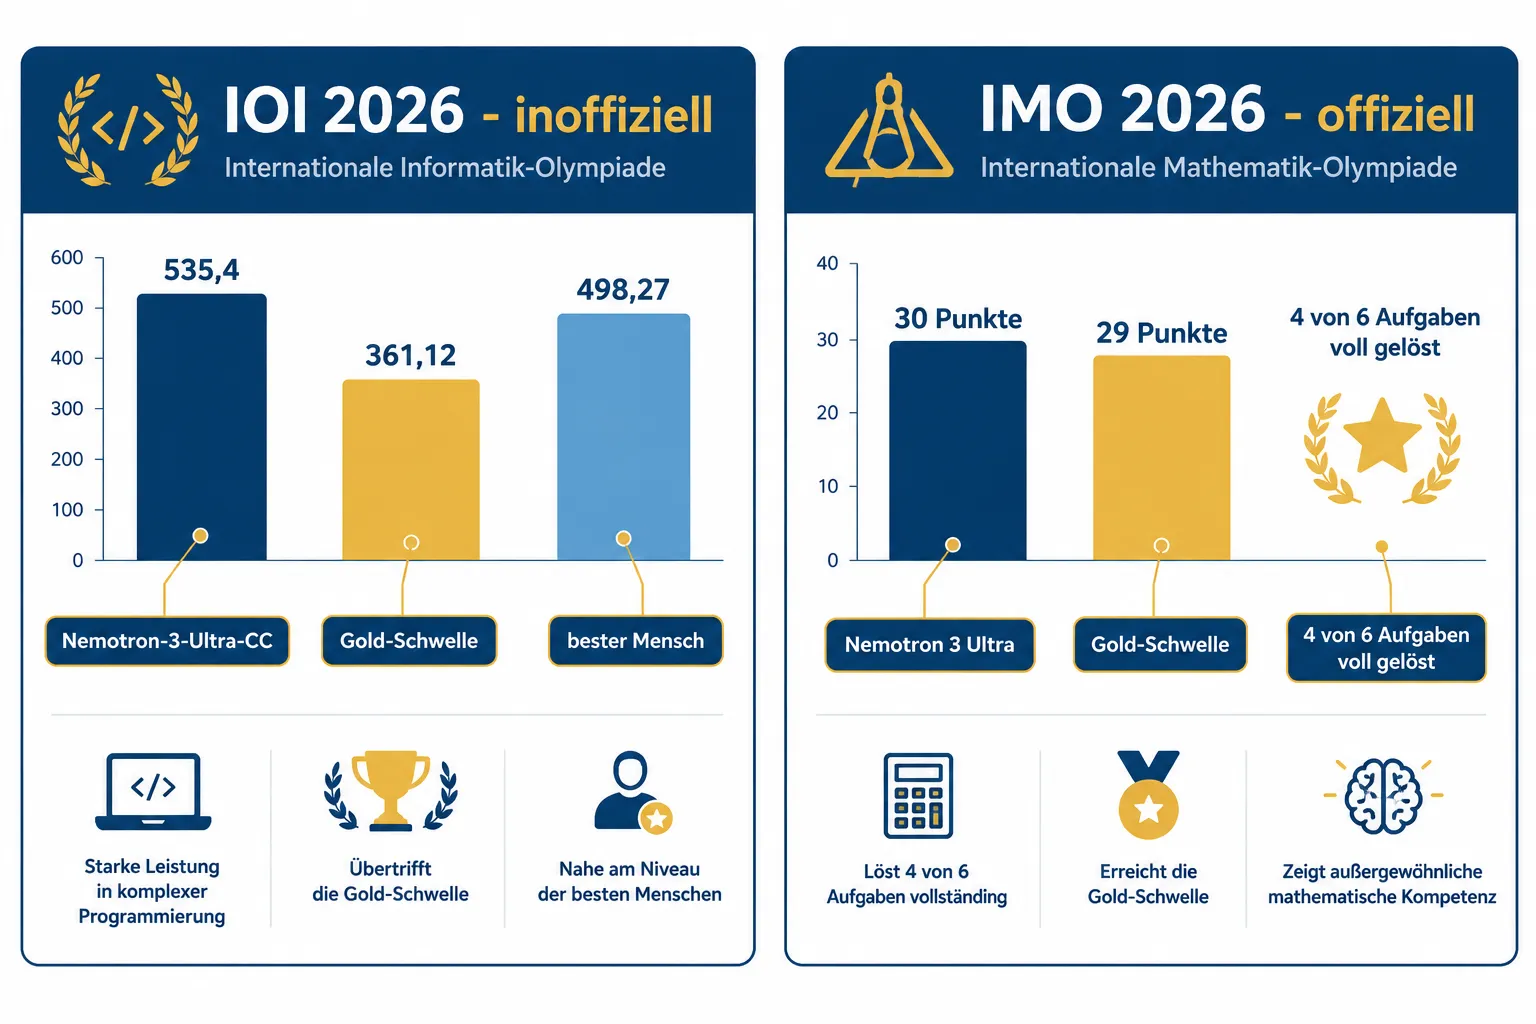
- IMO 2026 (offiziell verifiziert): Ein Nemotron-3-Ultra-System erreichte 30 von 42 Punkten, oberhalb der Gold-Schwelle von 29 Punkten, mit vollständiger Punktzahl bei 4 von 6 Aufgaben.
- IOI 2026 (inoffiziell): "Nemotron-3-Ultra-CC" erzielte 535,4 von 600 Punkten unter wettkampfähnlichen Bedingungen, deutlich über der Gold-Schwelle von 361,12 Punkten, aber nicht im offiziellen Ranking enthalten.
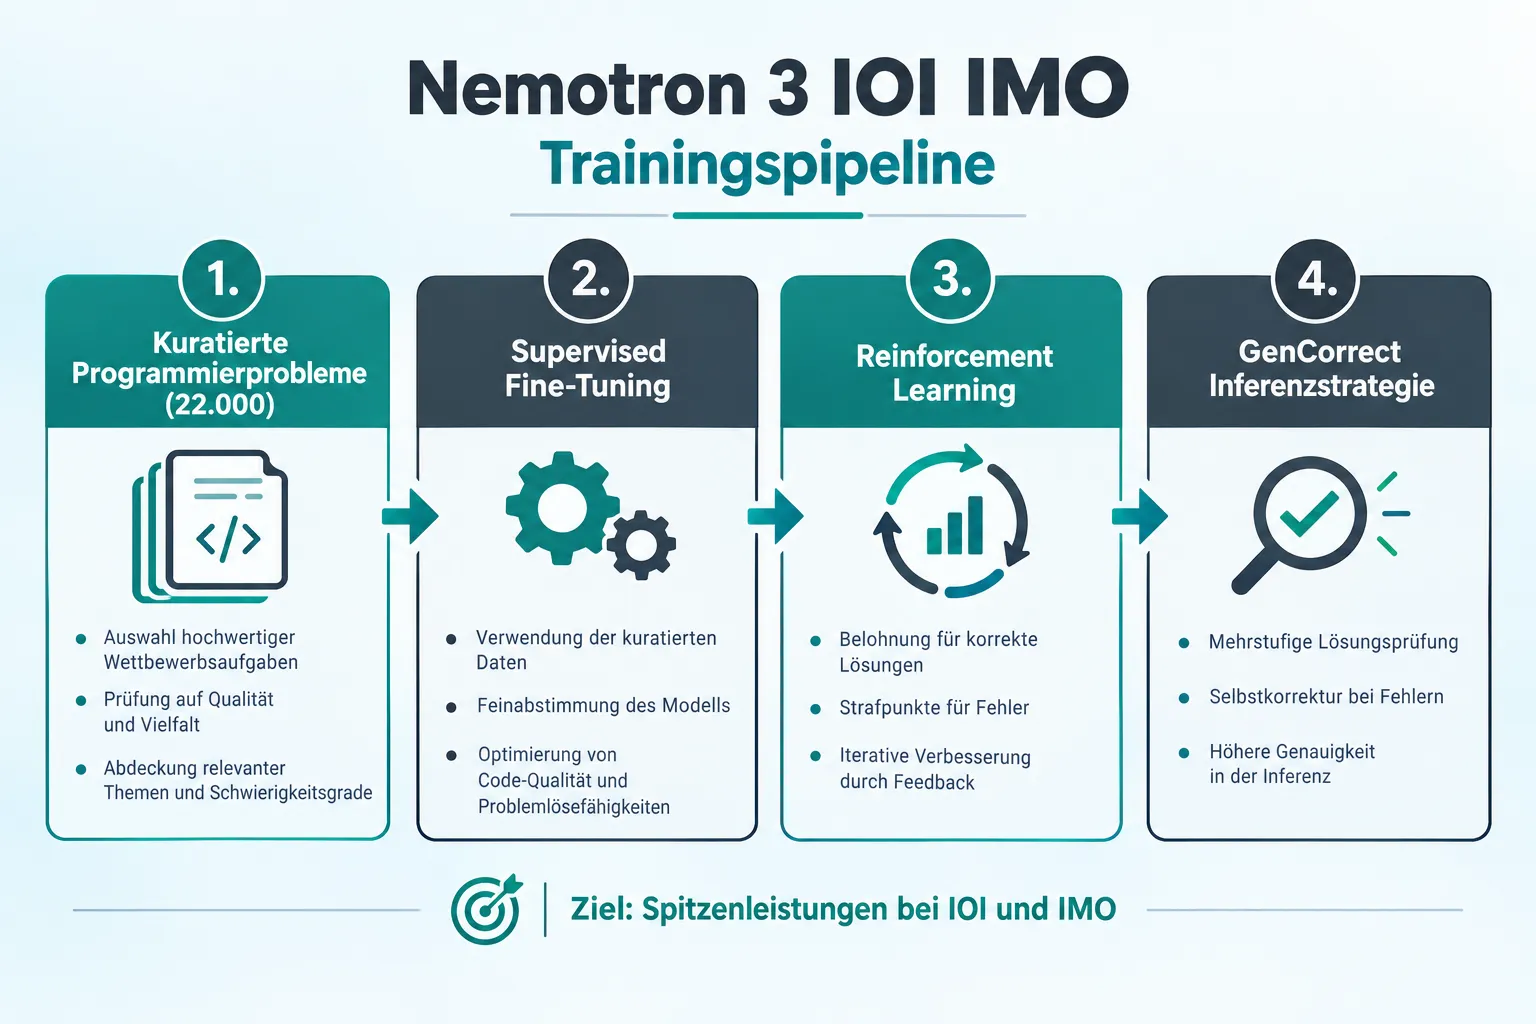
- Beide Systeme basieren auf dem gleichen methodischen Baukasten: Supervised Fine-Tuning, teils Reinforcement Learning und spezielle Inferenzstrategien wie "GenCorrect" beziehungsweise "Generate-Verify-Refine".
- Nvidia hat Modelle, Trainingsdaten und das komplette Rezept offen auf Hugging Face veröffentlicht, reproduzierbar für jeden mit passender Hardware.
- Nemotron 3 IOI IMO ist kein direkter Vergleich zu Konkurrenzmodellen wie GPT-5 oder Claude, sondern ein Nachweis, dass sich ein spezialisiertes Trainingsverfahren auf zwei völlig unterschiedliche Fachgebiete übertragen lässt.
Was sind IOI und IMO überhaupt?
Beide Wettbewerbe gelten als die anspruchsvollsten akademischen Olympiaden ihrer Disziplin und ziehen jährlich die besten Nachwuchstalente der Welt an.
Die International Olympiad in Informatics (IOI) ist der weltweit bedeutendste Programmierwettbewerb für Schülerinnen und Schüler. Teilnehmende lösen unter Zeitdruck komplexe algorithmische Aufgaben, die präzises Problemlösen, Effizienzdenken und fehlerfreie Implementierung erfordern. Die maximale Punktzahl liegt bei 600, verteilt über mehrere Aufgaben mit abgestuften Teilpunkten.
Die International Mathematical Olympiad (IMO) ist das mathematische Gegenstück. Hier geht es nicht um Code, sondern um strenge, nachvollziehbare Beweise für sechs anspruchsvolle Aufgaben aus Bereichen wie Algebra, Geometrie, Zahlentheorie und Kombinatorik. Die maximale Punktzahl beträgt 42, also sieben Punkte pro Aufgabe. Gold-, Silber- und Bronzeschwellen werden jedes Jahr neu anhand der Leistungen der menschlichen Teilnehmenden festgelegt.
Für ein KI-System, Aufgaben auf diesem Niveau zu lösen, bedeutet das: mehrstufiges logisches Denken, algorithmische Kreativität und, bei der IMO, die Fähigkeit, Beweise in natürlicher Sprache so präzise zu formulieren, dass sie menschlichen Prüfern standhalten.
Nemotron 3 IOI IMO beim Programmierwettbewerb: Das IOI-2026-Ergebnis
Für die IOI 2026 entwickelte Nvidia das spezialisierte System "Nemotron-3-Ultra-CC". Es basiert auf Supervised Fine-Tuning und nutzt zusätzlich eine Inferenzstrategie namens "GenCorrect", bei der das Modell eigene Lösungsentwürfe generiert, überprüft und korrigiert, bevor es eine finale Antwort abgibt.
Das Ergebnis: 535,4 von 600 Punkten. Zur Einordnung der Dimension dieses Resultats:
| Kennzahl | Punktzahl |
|---|---|
| Nemotron-3-Ultra-CC (2026) | 535,4 von 600 |
| Gold-Schwelle IOI 2026 | 361,12 |
| Bester menschlicher Teilnehmer 2026 | 498,27 |
Das System lag damit sowohl deutlich über der Gold-Schwelle als auch über der Leistung des besten menschlichen Wettkämpfers. Entscheidend ist aber die Einordnung, die Nvidia selbst vornimmt: Der Lauf fand unter den gleichen Zeit-, Internetzugriffs- und Einreichungsbedingungen wie bei menschlichen Teilnehmenden statt, war aber nicht Teil des offiziellen IOI-Rankings. Es handelt sich also um einen inoffiziellen, nicht von Wettkampfrichtern überwachten Testlauf außerhalb des regulären Wettbewerbsrahmens.
Diese Unterscheidung ist für die Bewertung von Nemotron 3 IOI IMO zentral: Ein beeindruckendes Ergebnis unter vergleichbaren Bedingungen ist nicht dasselbe wie eine offizielle Platzierung in einem realen Wettbewerb mit menschlichen Konkurrenten und unabhängiger Aufsicht.
Nemotron 3 IOI IMO bei der Mathematik-Olympiade: Das offizielle IMO-2026-Ergebnis
Anders verhält es sich beim zweiten Teil der Nemotron 3 IOI IMO Erfolgsgeschichte. Für die IMO 2026 kombinierte Nvidia ein allgemeines Nemotron-3-Ultra-Modell mit SFT- und RL-Checkpoints in einer "Generate-Verify-Refine"-Pipeline, das System generiert einen Lösungsvorschlag, überprüft ihn auf logische Lücken und verfeinert ihn iterativ.
Das Ergebnis: 30 von 42 Punkten, oberhalb der offiziellen Gold-Schwelle von 29 Punkten. Bei vier der sechs Aufgaben erzielte das System die volle Punktzahl. Der entscheidende Unterschied zum IOI-Resultat: Dieses Ergebnis wurde von offiziellen IMO-Gutachtern bewertet und gilt damit als offiziell verifiziert.
Bemerkenswert ist zudem die Methodik der Lösungsfindung. Die Antworten wurden ausschließlich in natürlicher Sprache formuliert, ohne formalen Beweis-Prover, ohne externe Werkzeuge und ohne Internetzugang. Das Modell musste also, wie ein menschlicher Teilnehmer, mathematische Argumentationsketten in klar verständlichem Text aufbauen, die einer strengen Prüfung durch Fachgutachter standhalten.
"Nemotron 3 IOI IMO zeigt zwei unterschiedliche Reifegrade der Verifikation: ein offiziell begutachtetes Gold-Ergebnis in Mathematik und ein inoffizielles, aber methodisch sauberes Testergebnis in der Informatik."
Das Rezept hinter Nemotron 3 IOI IMO: SFT, RL und GenCorrect
Hinter beiden Resultaten steckt ein gemeinsamer technischer Unterbau. Für das Coding-Training kuratierte Nvidia 22.000 Programmierprobleme und generierte dafür synthetische Reasoning-Traces, also nachvollziehbare Gedankengänge, mit denen die Modelle lernen, Probleme schrittweise zu durchdenken.
Daraus entstanden zwei Modellvarianten:
- Nemotron-3-Nano-CC: 30 Milliarden Gesamtparameter, davon 3 Milliarden aktiv, trainiert mit SFT und zusätzlichem Reinforcement Learning.
- Nemotron-3-Ultra-CC: 550 Milliarden Gesamtparameter, davon 55 Milliarden aktiv, trainiert ausschließlich mit Supervised Fine-Tuning.
Beide Modelle folgen dem Prinzip der "Mixture of Experts"-Architektur, bei der nur ein Bruchteil der Gesamtparameter pro Anfrage aktiv ist, ein Grund für die vergleichsweise effiziente Inferenz trotz enormer Modellgröße.
Der eigentliche Leistungsschub entsteht jedoch nicht allein durch das Training, sondern durch die Art, wie das Modell zur Testzeit arbeitet. Bei GenCorrect generiert das System mehrere Lösungsansätze, bewertet deren Konsistenz und korrigiert Fehler, bevor es eine Antwort abgibt. Bei der IMO-Pipeline läuft ein ähnliches Prinzip unter dem Namen "Generate-Verify-Refine". Beide Verfahren zeigen: Ein großer Teil der zusätzlichen Leistungsfähigkeit entsteht erst nach dem eigentlichen Training, durch intelligentere Nutzung der Rechenzeit während der Antwortgenerierung.
IOI 2025 als Referenzpunkt: Wie groß ist der Fortschritt wirklich?
Um die Entwicklung einzuordnen, lohnt ein Blick auf die Vorjahresdaten der IOI 2025, die Nvidia als internen Benchmark nutzte. Das kleinere Nano-Modell verbesserte sich dabei schrittweise:
| Trainingsstufe | Punktzahl (IOI 2025) |
|---|---|
| Vor Post-Training | 130 |
| Nach Supervised Fine-Tuning | 280 |
| Nach zusätzlichem Reinforcement Learning | 291 |
| Mit GenCorrect (Testzeit-Strategie) | 468 |
Die damalige Gold-Schwelle lag bei 438,3 Punkten, mit GenCorrect überschritt das kleine Nano-Modell diese Marke deutlich. Das größere Ultra-CC-Modell erreichte mit der gleichen Teststrategie 502 Punkte. Diese Zahlen zeigen zwei Dinge sehr klar: Erstens bringt jede einzelne Trainingsstufe einen messbaren Fortschritt. Zweitens liefert die Inferenzstrategie GenCorrect den größten einzelnen Leistungssprung, größer als SFT und RL zusammen. Genau dieses Muster bestätigte sich 2026 erneut, nun auf höherem Niveau.
Offene Veröffentlichung: Modelle, Daten und Benchmark auf Hugging Face
Ein zentraler Aspekt der Nemotron 3 IOI IMO Initiative ist die Offenheit der Veröffentlichung. Nvidia stellte Modelle, Trainingsdaten und das vollständige Rezept in der "Nemotron Labs IMO 2026 Collection" auf Hugging Face bereit. Dazu gehört auch ein neuer Benchmark namens "Nemotron-IMO-Bench" mit 200 Olympiade-Problemen, der zukünftigen Forschungsteams als Testgrundlage dient.
Besonders betont wird dabei: Es handelt sich nicht um eine reduzierte Marketing-Version, sondern um eine vollständige, reproduzierbare Dokumentation, ohne zurückgehaltene Geschäftsgeheimnisse. Jedes Team mit ausreichender Hardware kann das Verfahren nachvollziehen und auf eigene Problemstellungen übertragen. Offene Gewichte sind 2026 ein wiederkehrendes Muster bei großen Modell-Releases, wie etwa bei Reflection AIs Beam-Modell mit 501 Milliarden Parametern. Dieser offene Ansatz unterscheidet Nvidias Vorgehen von vielen anderen Ankündigungen im KI-Bereich, bei denen Ergebnisse präsentiert, aber Methoden nicht vollständig offengelegt werden.
Einordnung: Was Nemotron 3 IOI IMO wirklich bedeutet
Es wäre verkürzt, die Ergebnisse als simplen Beweis zu lesen, dass Nemotron 3 "schlauer" sei als konkurrierende Modelle wie GPT-5 oder Claude. Nvidia selbst betont die methodische Einschränkung beim IOI-Ergebnis ausdrücklich: Es ist inoffiziell und nicht im regulären Wettkampf-Ranking enthalten. Ein direkter Leistungsvergleich zwischen Modellen unterschiedlicher Hersteller lässt sich aus diesen Zahlen nicht seriös ableiten.
Die eigentliche Neuigkeit liegt woanders: Nvidia hat ein wiederverwendbares Spezialisierungs-Rezept entwickelt, bestehend aus kuratierten Trainingsdaten, Supervised Fine-Tuning, Reinforcement Learning und einer cleveren Inferenzstrategie, und dieses Rezept zweimal auf völlig unterschiedliche Fachgebiete angewendet: einmal auf algorithmisches Programmieren, einmal auf mathematisches Beweisen. In beiden Fällen erreichte das Ergebnis Weltklasse-Niveau. Diese Übertragbarkeit ist der eigentliche Fortschritt, den Entwicklerinnen und Entwickler aus der Nemotron 3 IOI IMO Geschichte mitnehmen sollten.
Fazit und nächste Schritte
Die Nemotron 3 IOI IMO Ergebnisse markieren einen bemerkenswerten Moment für spezialisierte KI-Systeme im Bereich des logischen Denkens. Das offizielle Gold-Niveau bei der IMO 2026 mit 30 von 42 Punkten ist ein verifizierter Meilenstein, während das inoffizielle IOI-Resultat mit 535,4 von 600 Punkten zwar beeindruckend, aber methodisch mit Vorsicht zu lesen ist. Wer beide Zahlen nebeneinander betrachtet, erkennt vor allem eines: Ein konsistentes Trainingsverfahren aus SFT, RL und intelligenter Testzeit-Strategie funktioniert über Fachgrenzen hinweg.
Für Entwicklerinnen und Entwickler, die sich praktisch mit dem Thema beschäftigen wollen, bieten sich konkrete nächste Schritte an: Die "Nemotron Labs IMO 2026 Collection" auf Hugging Face lohnt einen genauen Blick, ebenso der neue "Nemotron-IMO-Bench" als Testgrundlage für eigene Reasoning-Experimente. Wer eigene Modelle im Bereich komplexer Problemlösung trainieren möchte, findet in dem offen dokumentierten Rezept einen realistischen Ausgangspunkt, ganz ohne versteckte Geschäftsgeheimnisse.