Am 3. Oktober 2026, dem Tag der Deutschen Einheit, veröffentlichte ein Heidelberger Unternehmen mit rund 200 Mitarbeitenden ein KI-Modell, das in zentralen Benchmarks mit den Spitzenprodukten aus den USA und China mithalten will. Der Name: Aleph Alpha Kolibri. Das Besondere ist nicht nur die Leistung, sondern der Umstand, dass die vollständigen Modellgewichte offen zugänglich sind und das Training zu einem ungewöhnlich hohen Anteil auf deutschsprachigen Texten basiert.
Für deutsche Tech-Entscheider ist das mehr als eine Randnotiz. Aleph Alpha Kolibri ist ein konkretes Angebot an Behörden, Industrie und regulierte Branchen, die KI-Infrastruktur im eigenen Land betreiben wollen, statt sich ausschließlich auf amerikanische oder chinesische Cloud-Anbieter zu verlassen.
Inhaltsverzeichnis
Key Takeaways
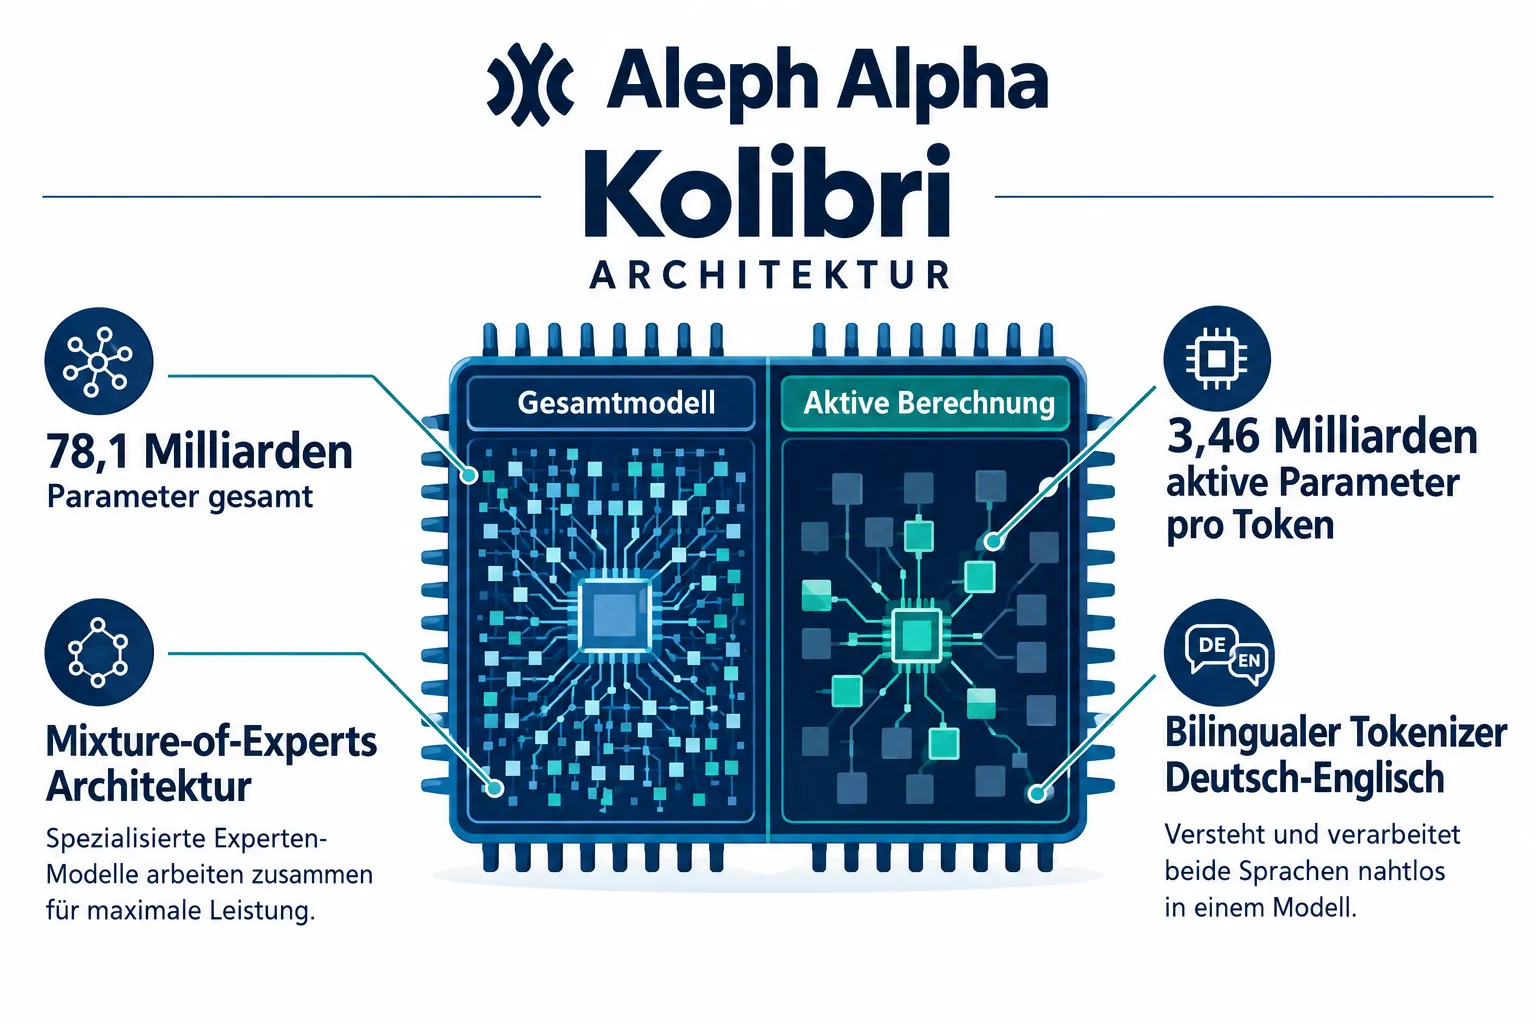
- Aleph Alpha Kolibri ist ein zweisprachiges Mixture-of-Experts-Modell mit 78,1 Milliarden Parametern insgesamt, von denen pro Token nur rund 3,46 Milliarden aktiv genutzt werden.
- Die Modellgewichte stehen unter Apache-2.0-Lizenz auf Hugging Face bereit; Code-Basis, Architektur und Trainingsmethoden selbst sind davon laut Model Card ausdrücklich ausgenommen.
- Rund 21 bis 23 Prozent der Trainingsdaten sind deutschsprachig, ergänzt durch einen eigens entwickelten bilingualen Tokenizer für Deutsch und Englisch.
- Benchmark-Werte wie 96,9 Prozent auf AIME 2025 stammen aus Herstellerangaben von Aleph Alpha und sind bislang nicht unabhängig bestätigt.
- Trainiert wurde auf 768 Nvidia-B200-GPUs in Rechenzentren in Deutschland und Finnland, was das Modell zu einem Beispiel europäischer KI-Infrastruktur macht.
Was ist Aleph Alpha Kolibri?
Aleph Alpha wurde 2019 in Heidelberg gegründet und beschäftigt heute rund 200 Menschen an vier Standorten in Deutschland. Das Unternehmen gilt neben dem französischen Anbieter Mistral AI als einer der wenigen europäischen Versuche, im globalen Wettlauf um große Sprachmodelle eine eigenständige Rolle zu spielen.
Mit Kolibri bringt Aleph Alpha ein Modell auf den Markt, das bewusst nicht als reines Forschungsprojekt gedacht ist, sondern als einsetzbares Werkzeug für Organisationen mit hohen Anforderungen an Datenschutz und Kontrolle. Der Name Kolibri passt zur technischen Idee dahinter: Ein Kolibri ist klein und effizient, bewegt sich aber mit bemerkenswerter Präzision. Genau das versucht die Mixture-of-Experts-Architektur des Modells technisch umzusetzen.
"Kolibri zeigt, dass wir in Deutschland über das Talent und die Expertise verfügen, um wettbewerbsfähige KI-Modelle zu entwickeln", erklärte Ilhan Scheer, CEO von Aleph Alpha, sinngemäß zur Veröffentlichung.
Scheer betonte zudem, dass es bei der Entwicklung europäischer KI-Modelle vor allem um Wahlfreiheit gehe: Organisationen sollen selbst entscheiden können, welche Infrastruktur, welchen Anbieter und welches Modell sie für sensible Anwendungen nutzen.
Technische Architektur von Aleph Alpha Kolibri
Kolibri ist als Mixture-of-Experts-Transformer (MoE) aufgebaut. Dieses Architekturprinzip unterscheidet sich grundlegend von klassischen, dicht verbundenen Sprachmodellen.
Die wichtigsten Kennzahlen im Überblick:
| Merkmal | Wert |
|---|---|
| Gesamtparameter | 78,1 Milliarden |
| Aktive Parameter pro Token | rund 3,46 Milliarden |
| Trainings-Kontextfenster | bis zu 262.144 Tokens |
| Serving-Kontextfenster | bis zu 1.048.576 Tokens (1 Million) |
| Trainings-Hardware | 768 Nvidia B200 GPUs |
| Trainingsstandorte | Deutschland und Finnland |
Der entscheidende Vorteil der MoE-Architektur liegt in der Recheneffizienz: Obwohl das Modell insgesamt 78,1 Milliarden Parameter besitzt, wird für die Verarbeitung eines einzelnen Tokens nur ein Bruchteil davon aktiviert, rund 3,46 Milliarden Parameter. Das Modell wählt dynamisch aus, welche "Experten"-Teilnetzwerke für eine bestimmte Eingabe am relevantesten sind. Das Ergebnis ist ein Modell, das in der Praxis deutlich günstiger zu betreiben ist als ein vergleichbar großes, dicht verbundenes Modell, ohne bei der Qualität nennenswert einzubüßen.
Interessant ist auch der Blick auf die Trainingsdaten: Laut technischem Report wurden für das Training unter anderem synthetische Daten genutzt, die mit den Modellen GLM-5.2/5.3 von Z.ai sowie Qwen3.8-27B erzeugt wurden. Das zeigt, dass selbst europäische Modellentwicklung heute stark auf einem globalen Ökosystem von Werkzeugen aufbaut, auch wenn die Souveränität am Ende beim fertigen Produkt und dessen Betrieb ansetzt.
Deutschsprachige Optimierung: Tokenizer und Trainingsdaten
Die auffälligste Besonderheit von Aleph Alpha Kolibri im internationalen Vergleich ist der hohe Anteil deutschsprachiger Trainingsdaten. Je nach Quelle liegt dieser Anteil zwischen rund 21 und 23 Prozent aller Pretraining-Tokens. Zum Vergleich: Die meisten großen westlichen Sprachmodelle trainieren überwiegend auf englischsprachigen Texten, Deutsch macht dort häufig nur einen kleinen einstelligen Prozentanteil aus.
Möglich wird diese Gewichtung unter anderem durch einen eigens entwickelten bilingualen Tokenizer für Deutsch und Englisch. Samuel Weinbach, Co-Founder und Co-Chief Research Officer von Aleph Alpha, erläuterte, dass dieser Tokenizer speziell darauf ausgelegt sei, deutsche Texte effizienter zu zerlegen als Standard-Tokenizer aus englischsprachig geprägter Forschung.
Das hat praktische Folgen: Ein Tokenizer, der deutsche Wörter mit weniger Einzeltokens abbildet, benötigt für denselben deutschen Text weniger Rechenschritte. Das spart nicht nur Rechenzeit und Kosten bei Deutsch-lastigen Anwendungen, es verbessert tendenziell auch, wie gut das Modell grammatikalische Eigenheiten der deutschen Sprache wie zusammengesetzte Substantive oder Flexionsformen erfasst.
Lizenz und Verfügbarkeit: Apache 2.0 mit Einschränkungen
Aleph Alpha stellt die vollständigen Modellgewichte von Kolibri unter dem Namen Aleph-Alpha/Kolibri-1 auf Hugging Face bereit. Die Lizenz dafür ist Apache 2.0, eine der liberalsten Open-Source-Lizenzen überhaupt, die auch kommerzielle Nutzung, Modifikation und Weiterverbreitung ohne Lizenzgebühren erlaubt.
Wichtig ist hier eine Einschränkung, die in der offiziellen Model Card klar benannt wird: Die Apache-2.0-Lizenz bezieht sich ausschließlich auf die veröffentlichten Modellgewichte. Die zugrunde liegende Code-Basis, die genaue Modellarchitektur und die Trainingsmethoden selbst sind davon ausdrücklich nicht erfasst. Wer Kolibri einsetzt, kann die Gewichte also frei nutzen und anpassen, erhält damit aber nicht automatisch Einblick in oder Rechte an der gesamten Entwicklungsmethodik dahinter.
Für IT-Verantwortliche bedeutet das in der Praxis:
- Die Gewichte lassen sich lokal herunterladen und auf eigener Infrastruktur betreiben.
- Eine Fine-Tuning-Anpassung an unternehmensspezifische Daten ist grundsätzlich möglich.
- Der zugrunde liegende Trainingscode bleibt proprietär bei Aleph Alpha.
- Rechtlich sollte vor einem produktiven Einsatz die genaue Model Card geprüft werden, insbesondere bei abgeleiteten kommerziellen Produkten.
Benchmark-Werte von Kolibri: Was die Zahlen wirklich bedeuten
Aleph Alpha veröffentlichte zur Markteinführung mehrere Benchmark-Ergebnisse, die das Modell in eine Reihe mit führenden internationalen Systemen stellen sollen. Diese Werte stammen ausschließlich aus Herstellerangaben und wurden zum Zeitpunkt der Veröffentlichung noch nicht von unabhängigen Dritten nachgeprüft oder reproduziert.
| Benchmark | Angegebener Wert (Herstellerangabe) |
|---|---|
| AIME 2025 (Mathematik, Englisch) | 96,9 Prozent |
| AIME 2026 (Mathematik) | 96 Prozent |
| GPQA Diamond (Fachwissen) | 84,3 Prozent |
| LiveCodeBench v6 (Programmierung) | 85,9 Prozent |
Diese Zahlen klingen beeindruckend, sollten aber mit der nötigen Vorsicht eingeordnet werden. Benchmark-Ergebnisse, die von einem Anbieter selbst veröffentlicht werden, hängen stark davon ab, wie die Tests durchgeführt wurden, welche Prompt-Varianten verwendet wurden und ob das Modell auf genau diese Benchmark-Arten hin optimiert wurde. Für eine belastbare Einordnung braucht es unabhängige Tests durch externe Forschungseinrichtungen oder Community-Benchmarks, die bei Kolibri zum Zeitpunkt der Veröffentlichung noch ausstehen.
Für Entscheider in Unternehmen bedeutet das praktisch: Die veröffentlichten Werte können als erster Hinweis auf die Leistungsfähigkeit dienen, sollten vor einer Kaufentscheidung oder einem größeren Pilotprojekt aber durch eigene Tests mit unternehmensrelevanten Aufgaben ergänzt werden.
Einsatzbereiche: Behörden, Industrie und regulierte Branchen
Aleph Alpha positioniert Kolibri explizit nicht als allgemeines Chat-Produkt für Endverbraucher, sondern als Infrastruktur-Baustein für Organisationen mit hohen regulatorischen Anforderungen. Im Fokus stehen laut Unternehmensangaben:
- Öffentliche Verwaltung und Behörden, die KI-Anwendungen nicht auf US-amerikanischen oder chinesischen Cloud-Servern betreiben wollen oder dürfen.
- Automobilzulieferer, die vertrauliche Konstruktions- und Prozessdaten schützen müssen.
- Halbleiterfertigung, wo geistiges Eigentum und Produktionsgeheimnisse besonders sensibel sind.
- Luft- und Raumfahrtindustrie, in der Exportkontrollen und Sicherheitsauflagen den Einsatz externer Cloud-KI stark einschränken.
Der gemeinsame Nenner dieser Branchen ist der Wunsch nach On-Premise-Betrieb: KI-Modelle sollen auf eigener oder zumindest europäischer Infrastruktur laufen, mit dokumentierter Datenherkunft und im Einklang mit DSGVO und dem EU-AI-Act. Ein offen verfügbares Modell wie Kolibri, das sich ohne Abhängigkeit von einer externen API lokal betreiben lässt, passt genau in dieses Anforderungsprofil.
Aleph Alpha Kolibri im europäischen Kontext
Die Veröffentlichung von Kolibri steht nicht isoliert da. Nur drei Tage später, am 6. Oktober 2026, brachte das französische Unternehmen Mistral AI sein Modell Mistral Large 4 heraus, intern auch "Le Chonk" genannt, mit rund einer Billion Parametern und 49 bis 52 Milliarden aktiven Parametern. Wichtig zur Einordnung: Mistral AI und Aleph Alpha Kolibri sind zwei völlig unterschiedliche Unternehmen aus zwei unterschiedlichen Ländern, die unabhängig voneinander jeweils eigene Modelle veröffentlicht haben.
Dennoch werden beide Unternehmen in der Branchenberichterstattung häufig gemeinsam genannt, weil sie als die zwei sichtbarsten europäischen "Champions" im globalen KI-Wettbewerb gegen US-Anbieter wie OpenAI oder Google und chinesische Anbieter wie DeepSeek oder Alibaba gelten. Beide Unternehmen verfolgen dabei unterschiedliche Schwerpunkte: Mistral AI setzt stärker auf sehr große, breit einsetzbare Modelle, während Aleph Alpha mit Kolibri gezielt auf Effizienz, deutschsprachige Optimierung und regulierte Branchen in Deutschland zielt.
Kritische Einordnung: Was noch offen bleibt
Trotz der beeindruckenden Eckdaten gibt es einige Punkte, die Entscheider vor einem produktiven Einsatz berücksichtigen sollten. Die Benchmark-Werte sind, wie erwähnt, bislang unabhängig nicht bestätigt. Die Lizenzsituation ist differenzierter als eine einfache "Open Source"-Einordnung vermuten lässt, da Architektur und Trainingscode proprietär bleiben. Und auch wenn ein hoher Anteil deutschsprachiger Trainingsdaten die Sprachqualität verbessern kann, ersetzt das keine unabhängige Prüfung der Modellqualität in konkreten Geschäftsanwendungen.
Häufig gestellte Fragen zu Aleph Alpha Kolibri
Ist Kolibri komplett Open Source? Die Modellgewichte stehen unter Apache-2.0-Lizenz frei zur Verfügung. Code-Basis, Architektur und Trainingsmethoden selbst sind laut Model Card davon ausgenommen.
Für wen eignet sich Kolibri besonders? Das Modell richtet sich an Behörden und regulierte Industrien wie Automobilzulieferer, Halbleiterfertigung und Luft- und Raumfahrt, die On-Premise-Betrieb und dokumentierte Datenherkunft benötigen.
Sind die Benchmark-Werte unabhängig bestätigt? Nein. Die veröffentlichten Zahlen wie 96,9 Prozent auf AIME 2025 stammen aus Herstellerangaben von Aleph Alpha und wurden bislang nicht durch unabhängige Dritte nachgeprüft.
Fazit und nächste Schritte
Aleph Alpha Kolibri markiert einen bemerkenswerten Schritt für die deutsche KI-Landschaft: ein leistungsfähiges, zweisprachiges Modell mit effizienter Mixture-of-Experts-Architektur, offenen Gewichten und einem klaren Fokus auf deutschsprachige Nutzung und regulierte Branchen. Die Kombination aus hohem Anteil deutscher Trainingsdaten, eigenem bilingualem Tokenizer und europäischer Trainingsinfrastruktur in Deutschland und Finnland unterscheidet Kolibri spürbar von rein englischsprachig geprägten Modellen.
Gleichzeitig gilt: Die vom Hersteller veröffentlichten Benchmark-Werte sollten als erster Anhaltspunkt und nicht als endgültiges Qualitätsurteil verstanden werden. Unternehmen und Behörden, die den Einsatz von Kolibri erwägen, sollten in einem nächsten Schritt eigene Testläufe mit praxisnahen Aufgaben durchführen, die Lizenzbedingungen für den konkreten Anwendungsfall genau prüfen und die Infrastrukturanforderungen für einen On-Premise-Betrieb realistisch kalkulieren. Wer diese Hausaufgaben macht, erhält mit Kolibri ein Werkzeug, das echte Alternativen zu US-amerikanischen und chinesischen KI-Angeboten eröffnet, ohne auf Kompromisse bei Datenschutz und Kontrolle eingehen zu müssen.